
Transformer a mechanismus pozornosti (attention) – architektura za moderními jazykovými modely
Písmeno T v názvech jako GPT znamená Transformer. Jde o architekturu neuronových sítí, kterou v roce 2017 představil tým výzkumníků z Googlu v článku „Attention Is All You Need“. Dnes stojí za většinou velkých jazykových modelů, překladačů i řady systémů pro obrázky a zvuk. Tento článek vysvětluje co Transformer je, co znamená „pozornost“, proč byl průlom a jaké důsledky má pro uživatele: délka kontextu, cena, rychlost i omezení.
Informace vycházejí z abstraktu studie Attention Is All You Need (arXiv:1706.03762; Vaswani, Shazeer, Parmar, Uszkoreit, Jones, Gomez, Kaiser, Polosukhin; první verze 12. 6. 2017, poslední z 2. 8. 2023), z úvodu Google – Introduction to LLMs a z kurzu Google ML Crash Course – Embeddings (stav k 14. 11. 2026). Zjednodušení slouží k pochopení principu; nejde o technický návod.
Související články: Tokeny a kontextové okno, Jak funguje umělá inteligence a Historie umělé inteligence.
Aktualizováno: listopad 2026.
Problém, který Transformer řešil
Jazykový model podle Googlu odhaduje pravděpodobnost, že se token (nebo posloupnost tokenů) objeví v delší posloupnosti: dostane větu s mezerou a přiřadí pravděpodobnosti možným slovům. Aby to dělal dobře, potřebuje kontext: slovo „pomeranč“ znamená v různých větách ovoce či barvu. Starší přístupy měly omezení:
- N-gramy používají jen několik předchozích slov, takže mají málo kontextu; dlouhé n-gramy se v trénovacích datech vyskytují zřídka.
- Rekurentní neuronové sítě (RNN) zpracovávají jeden token po druhém, takže získají víc kontextu než n-gramy, ale jejich kontext je stále omezený a trénování na dlouhých posloupnostech komplikuje problém mizejícího gradientu.
Podle Googlu velké jazykové modely dokážou vyhodnocovat celý kontext najednou; právě to umožnila architektura Transformer.
Co navrhli autoři Transformeru
Podle abstraktu studie je Transformer nová síťová architektura založená výhradně na mechanismech pozornosti, bez rekurence a bez konvolucí. Do té doby nejlepší modely pro převod posloupností (například překlad) spojovaly kodér a dekodér pomocí pozornosti, ale ještě využívaly rekurentní či konvoluční sítě. Transformer používá jen pozornost.
Autoři uvádějí výhody: model je kvalitnější, lépe paralelizovatelný a vyžaduje výrazně méně času na trénování. Výsledky na překladových úlohách WMT 2014: 28,4 BLEU pro angličtinu–němčinu (zlepšení o víc než 2 body BLEU nad dosavadními nejlepšími výsledky včetně souborů modelů) a 41,8 BLEU pro angličtinu–francouzštinu (nový rekord pro jediný model po 3,5 dnech tréninku na osmi GPU). Model si dobře vedl i na jiné úloze, syntaktické analýze angličtiny.
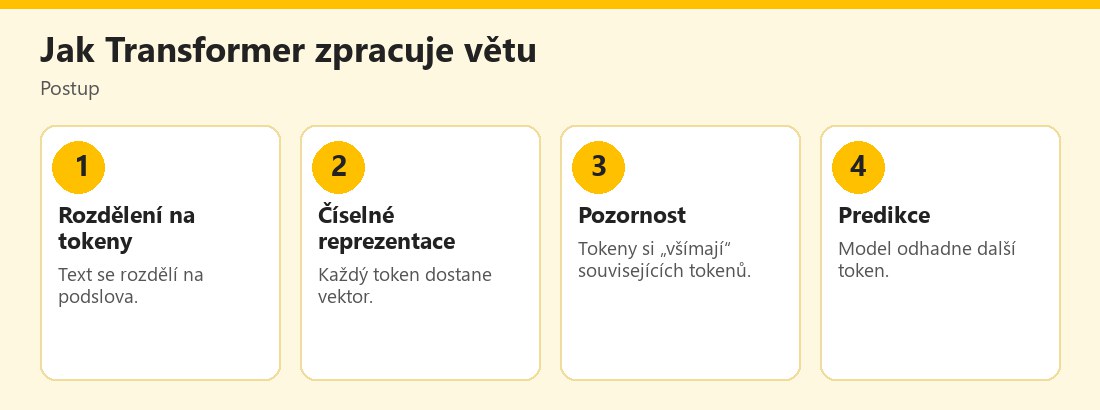 Postup zpracování věty Transformerem – vlastní infografika
Co je „pozornost“
Pozornost (attention) lze přirovnat k tomu, jak čtenář při porozumění věty přihlíží k důležitým slovům. Když model zpracovává slovo, zvažuje, která další slova v textu jsou pro jeho význam podstatná, a podle toho z nich „čerpá“ informace. Například ve větě „Soudce uvěřil svědkovi, protože mu to dávalo smysl“ musí model určit, ke komu se vztahuje „mu“; pozornost mu pomáhá spojit slovo s relevantním místem v textu, i když je daleko.
Kurz Googlu o embeddingech připomíná, že jednotlivé tokeny se v neuronové síti reprezentují jako číselné vektory; viz Embeddingy a vektorové vyhledávání. Pozornost pracuje s těmito reprezentacemi a počítá, jak moc se jednotlivé tokeny mají ovlivňovat navzájem. Je to zjednodušený obraz; matematické detaily (dotazy, klíče a hodnoty, více „hlav“ pozornosti) jsou předmětem odborných textů.
Proč byl Transformer průlom
- Paralelizace. Rekurentní sítě zpracovávají token po tokenu, takže nelze využít moderní grafické čipy naplno. Transformer zpracovává tokeny současně, což podle autorů zkracuje čas trénování.
- Delší kontext. Pozornost umožňuje spojit i vzdálená místa textu.
- Škálovatelnost. Architektura se dobře zvětšuje; to vedlo k velkým jazykovým modelům s miliardami parametrů.
- Univerzálnost. Stejný princip se uplatnil v překladu, generování textu, obrázcích, zvuku i multimodálních modelech; viz Multimodální AI.
Důsledky pro uživatele
- Kontextové okno. Počet tokenů, které model „vidí“ najednou, je omezený; cena a rychlost obvykle rostou s délkou kontextu; viz Tokeny a kontextové okno.
- Cena podle tokenů. Zpracování každého tokenu stojí výpočetní výkon; to se promítá do ceny služeb.
- Halucinace. Model generuje pravděpodobné pokračování textu, ne ověřené fakta; viz Halucinace.
- Pozornost není porozumění v lidském smyslu. Model počítá statistické vztahy mezi tokeny; to může vypadat jako chápání, ale není to totéž.
- Uvažování a nástroje. Moderní reasoning modely před odpovědí používají skryté uvažovací tokeny; viz Reasoning modely. Agentní systémy kombinují model s nástroji a pamětí; viz AI agent, nebo workflow?.
Mýty a omezení
- „Transformer přemýšlí jako člověk.“ Ne; jde o matematický model, který se učí z dat.
- „Větší kontext vždy znamená lepší odpovědi.“ Ne nutně; model může důležité informace v dlouhém textu přehlédnout.
- „Pozornost zajišťuje pravdivost.“ Ne; pozornost vybírá relevantní kontext, ale pravdivost nezaručuje.
- „Transformer je poslední architektura.“ Výzkum pokračuje; Transformer je dnes dominantní, ale vznikají i další přístupy. Konkrétní vývoj sledujte v odborných zdrojích.
Jak se o tématu dozvědět víc
Pro laiky je dobrým začátkem úvod Google – Introduction to LLMs, pro zájemce o matematiku původní článek na arXiv. Praktické pojmy (tokeny, kontext, RAG) viz RAG a fine-tuning a Slovník pojmů umělé inteligence.
Od Transformeru k dnešním modelům
Původní Transformer měl dvě části: kodér (zpracovává vstup) a dekodér (vytváří výstup), a byl navržen pro překlad. Moderní jazykové modely často používají jen jednu z částí a jsou trénovány k předpovídání dalšího tokenu v obrovských textových souborech. Základní myšlenka ale zůstává: pozornost určuje, které části kontextu jsou při predikci důležité. Na tento základ navazují další techniky: ladění na instrukcích a zpětné vazbě od lidí, zpřesňování pomocí vyhledávání (RAG), používání nástrojů a uvažovací režimy; viz Jak se trénuje AI model a Reasoning modely. Dokumentace poskytovatelů, například OpenAI, uvádí, že uvažovací tokeny zabírají místo v kontextovém okně a účtují se jako výstup, což je přímý důsledek toho, jak Transformer s tokeny pracuje.
Proč je to důležité i pro běžné používání
Znalost principu vám pomůže psát lepší zadání. Protože model „čte“ celý kontext najednou a vyhodnocuje relevanci jednotlivých částí, pomáhá:
- uvést důležité informace jasně a na začátku,
- strukturovat zadání (cíl, omezení, formát výstupu),
- nevkládat zbytečně dlouhé a nesouvisející texty, které odvádějí pozornost,
- při dlouhých dokumentech je rozdělit a postupně shrnovat,
- ověřit klíčové údaje v odpovědi.
Obecné zásady zadávání viz Prompt engineering – jak psát prompty. Anthropic ve své dokumentaci uvádí, že před úpravami zadání je dobré mít jasně definována kritéria úspěchu a způsob jejich ověření (Prompt engineering overview).
Co se z architektury nepozná
Z toho, že model používá Transformer, nelze usuzovat na jeho kvalitu, bezpečnost ani etiku. Důležité jsou data, způsob trénování, doladění, ochranná opatření a dokumentace; viz Model cards a NIST AI RMF. Pokud o modelu rozhodujete ve firmě či škole, ptejte se na tyto věci, ne jen na „architekturu“.
Praktický příklad (smyšlený)
Student čte, že chatbot „zapomněl“ začátek dlouhého zadání. Učitel mu vysvětlí: model vidí jen omezený počet tokenů a při velmi dlouhém textu může důležité informace „přehlédnout“. Student zadání zkrátí, důležité body přesune na začátek i konec a požádá model o shrnutí zadání vlastními slovy, aby ověřil porozumění. Příklad je smyšlený.
Transformer (2017) nahradil rekurentní sítě mechanismem pozornosti: zpracovává tokeny paralelně a dokáže spojit vzdálené části textu. Právě on stojí za moderními jazykovými modely, ale nezaručuje pravdivost.
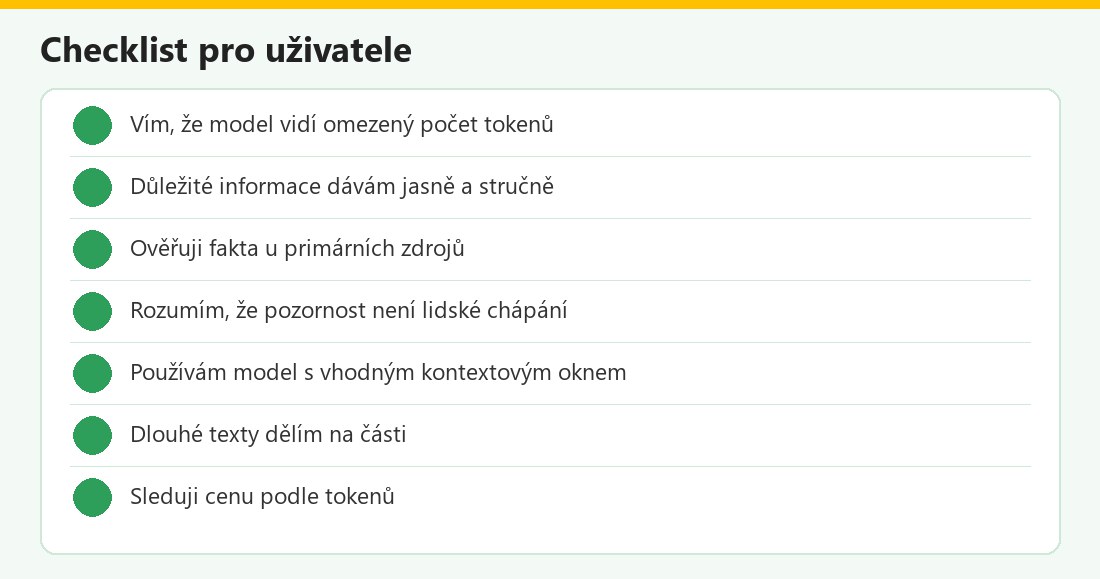 Kontrolní seznam – vlastní infografika
Transformer v kostce
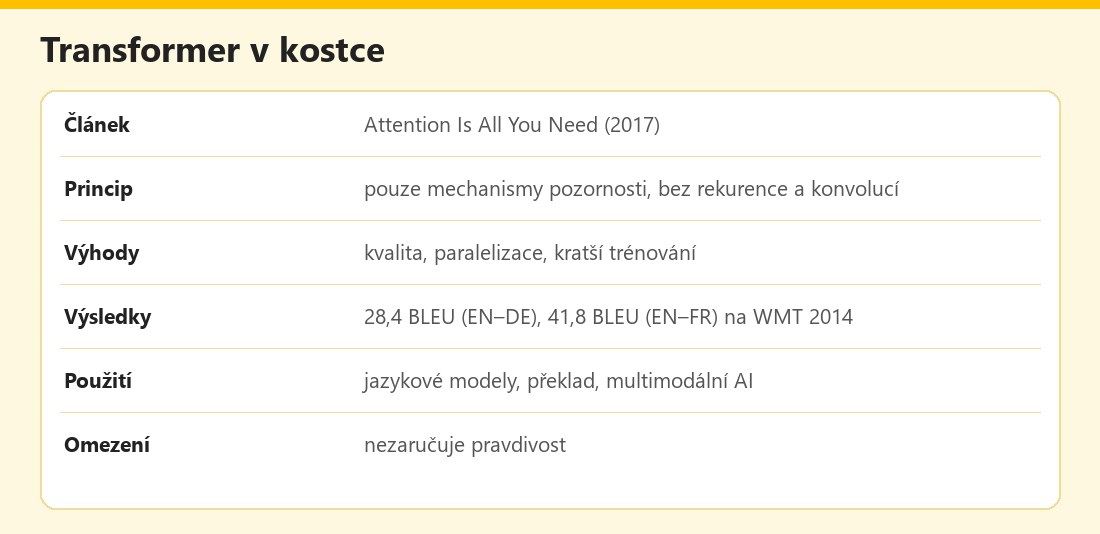 Základní údaje – vlastní infografika
Výhody a nevýhody
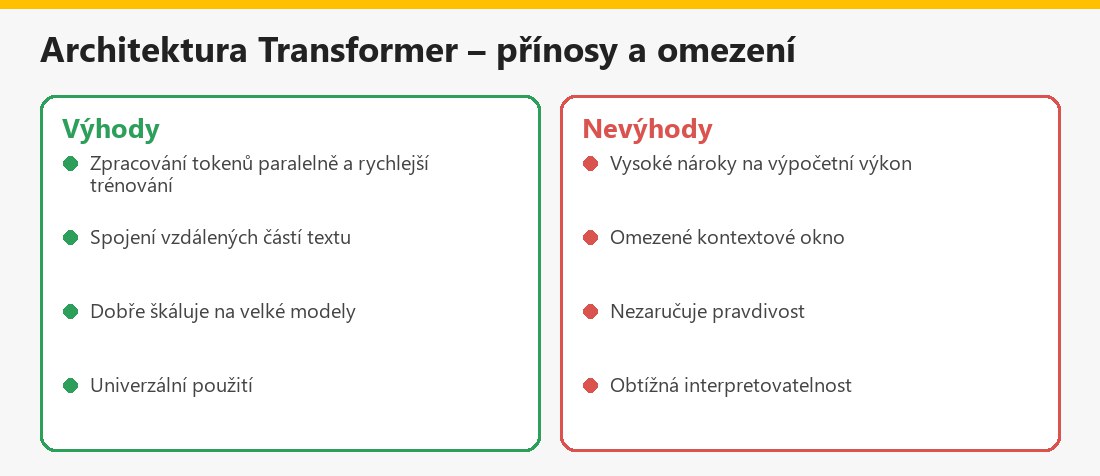 Souhrn – vlastní infografika
Související články
V kategorii Základy a principy AI najdete také Generativní vs. klasická AI a Jak se trénuje AI model.
Shrnutí
Transformer je architektura z roku 2017, která místo rekurence a konvolucí používá mechanismus pozornosti. Je kvalitnější, lépe paralelizovatelná a rychleji se trénuje; na překladových úlohách dosáhla 28,4 a 41,8 BLEU. Stojí za dnešními jazykovými modely, ale nezaručuje pravdivost a má omezené kontextové okno. Nejde o technický návod.
Často kladené otázky k Transformeru
Co je Transformer?
Architektura neuronových sítí založená na mechanismech pozornosti, představená v článku Attention Is All You Need (2017).
Co je pozornost?
Mechanismus, kterým model zvažuje, které části vstupu jsou pro význam aktuálního tokenu důležité.
Proč je rychlejší než rekurentní sítě?
Zpracovává tokeny paralelně, což zkracuje čas trénování.
Co znamená T v GPT?
Transformer.
Zaručuje pozornost pravdivost?
Ne, vybírá relevantní kontext, ne pravdivé informace.
Proč má model omezené okno?
Zpracování dlouhého kontextu je výpočetně náročné; kontext je omezen počtem tokenů.
Je Transformer jediná architektura?
Je dominantní, ale výzkum pokračuje.
Je to technický návod?
Ne, jde o zjednodušené vysvětlení.
