
Co je opravdu open-source AI – definice OSI, čtyři svobody a rozdíl oproti otevřeným váhám
Nabídka „otevřených“ modelů umělé inteligence roste: lze si stáhnout model, spustit ho na vlastním počítači a upravit. Slovo „open source“ se ale používá volně, i když část modelů zveřejňuje jen váhy (naučené parametry), nikoli kód ani informace o trénovacích datech. Open Source Initiative (OSI), organizace, která dlouhodobě definuje pojem otevřeného softwaru, proto vydala Open Source AI Definition (OSAID 1.0). Tento článek vysvětluje, co definice požaduje, v čem se liší od pouhého „open-weight“ a co z toho plyne pro uživatele a firmy.
Informace vycházejí z Open Source AI Definition 1.0 (OSI) a z obecných zásad rámce NIST AI RMF a úvodu Google – Introduction to LLMs (stav k 14. 11. 2026). Definice OSI není právním předpisem; konkrétní licence si vždy přečtěte. Nejde o právní poradenství.
Související články: Open-source AI modely – Llama a Mistral, Lokální AI doma – Ollama a Jak se trénuje AI model.
Aktualizováno: listopad 2026.
Čtyři svobody
Podle OSI musí systém umělé inteligence, který se označuje za open source, uživatelům zaručit svobodu:
- používat systém k jakémukoli účelu bez žádosti o povolení,
- studovat, jak funguje, a prohlížet jeho součásti,
- upravovat ho k jakémukoli účelu, včetně změny výstupů,
- sdílet ho (s úpravami či bez) k jakémukoli účelu.
Tyto svobody se vztahují jak na celý systém, tak na jeho jednotlivé prvky. K jejich uplatnění je nutný přístup k „preferované formě pro úpravy“ (preferred form to make modifications).
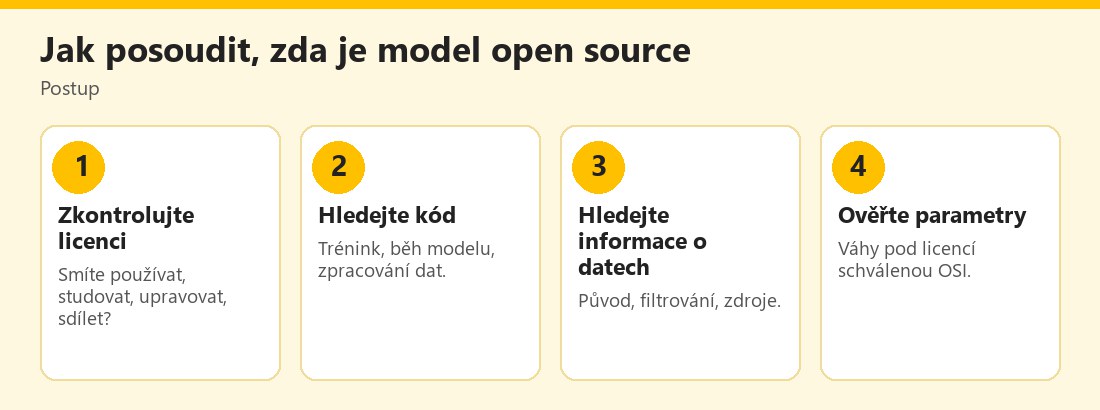 Postup posouzení, zda je AI model open source – vlastní infografika
Tři povinné složky
OSAID 1.0 uvádí, že preferovaná forma pro úpravy modelu strojového učení zahrnuje tři prvky:
1. Informace o datech (data information). Dostatečně podrobný popis trénovacích dat, aby zkušená osoba dokázala postavit v podstatě rovnocenný systém. Zahrnuje úplný popis dat (včetně těch, která nelze sdílet), jejich původ, jak byla získána a filtrována, postupy označování a seznam veřejných a třetích zdrojů. Informace o datech musí být dostupné za podmínek schválených OSI.
2. Kód. Úplný zdrojový kód použitý k trénování i běhu systému, včetně zpracování dat, tréninku, validace, inference a architektury modelu. Musí být pod licencemi schválenými OSI.
3. Parametry. Parametry modelu, například váhy či konfigurační nastavení, případně i mezistupně tréninku a závěrečný stav optimalizátoru. Musí být dostupné za podmínek schválených OSI.
Licence mohou vyžadovat, aby upravené verze byly zveřejněny za stejných podmínek jako originál.
Open-weight není totéž
OSI vysvětluje rozdíl takto:
- AI model tvoří architektura, parametry (včetně vah) a inferenční kód.
- Váhy jsou naučené parametry nad architekturou, které z vstupů vytvářejí výstupy.
- „Open Source modely“ a „open source váhy“ musí obsahovat informace o datech a kód použité k odvození těchto parametrů. Pouhé zveřejnění vah definici nesplňuje.
Definice sama pojem „open-weight“ samostatně nevymezuje. Z praktického hlediska to znamená: pokud poskytovatel zveřejní jen váhy (často s omezující licencí), můžete model spustit, ale nemusíte vědět, na čem byl natrénován, ani ho zcela reprodukovat. To má význam pro důvěru, bezpečnost i právní jistotu.
Proč na rozdílu záleží
- Transparentnost: informace o datech umožňují posoudit zkreslení, autorská práva a soukromí; viz Rizika AI – bias a diskriminace.
- Reprodukovatelnost: kód a data umožňují ověřit výsledky.
- Právní jistota: licence určuje, co smíte dělat; „otevřený“ model může mít omezení (například zákaz určitých použití).
- Bezpečnost: při studiu komponent lze snadněji odhalit slabiny; zároveň otevřenost znamená, že model mohou použít i zlovolní aktéři, a proto je třeba přistupovat k rizikům uvážlivě; viz Jailbreak AI modelů.
- Nezávislost: model lze provozovat lokálně bez posílání dat do cloudu; viz Lokální AI doma – Ollama.
Jak číst licence AI modelů
Než model nasadíte, zkontrolujte:
- Smíte ho použít komerčně?
- Smíte ho upravovat a sdílet upravenou verzi?
- Jsou v licenci omezení použití (například zakázané oblasti)?
- Jsou k dispozici informace o trénovacích datech?
- Je dostupný kód pro trénink a běh?
- Jaké povinnosti (uvedení zdroje, sdílení úprav) licence ukládá?
- Kdo odpovídá za škodu při chybě (obvykle nikdo, model je „tak, jak je“).
Pokud licence není schválena OSI, může jít o „zdrojově dostupný“ (source-available) či omezený model, i když je v marketingu označen jako otevřený. Pro firmy je rozumné nechat licenci posoudit právníkem.
Praktické důsledky
- Domácí uživatel: stažený model můžete spustit lokálně a vyzkoušet; pokud ho chcete použít k práci či zveřejnění výstupů, ověřte licenci.
- Firma: pro citlivá data je lokální provoz atraktivní, ale vyžaduje správu, zabezpečení a posouzení rizik; viz Firemní politika používání AI.
- Škola či veřejná správa: transparentnost modelu může být předpokladem pro důvěru a audit.
- Vývojář: otevřené komponenty usnadňují úpravy a výzkum, ale zodpovědnost za použití nese uživatel.
NIST ve svém dobrovolném rámci pro řízení rizik AI zdůrazňuje potřebu začlenit hlediska důvěryhodnosti do návrhu, vývoje, používání a hodnocení; otevřenost informací o modelu k tomu může přispět.
Data a soukromí: proč jsou „informace o datech“ citlivé téma
Jazykové modely se učí z obrovského množství textů, obrázků a dalších dat. Podle Googlu jazykový model odhaduje pravděpodobnost tokenu v posloupnosti; kvalita i vlastnosti modelu závisejí na tom, z čeho se učil (Introduction to LLMs). OSAID proto požaduje popis dat včetně těch, která nelze sdílet, jejich původ, způsob filtrování a postupy označování. Pro uživatele je to důležité ze tří důvodů: autorská práva (byla data získána legálně?), osobní údaje (obsahují data soukromé informace?) a zkreslení (jsou některé skupiny nadměrně či nedostatečně zastoupeny?). Viz také AI a ochrana osobních údajů (GDPR) a Etika AI a autorská práva.
Jak postupovat při výběru modelu pro firmu
- Určete účel a riziko. Co bude model dělat? Jaká data zpracuje?
- Vyberte kandidáty a porovnejte licence a dostupnost kódu, parametrů a informací o datech.
- Zkuste model na vlastních úlohách a změřte kvalitu; veřejné benchmarky nemusí odpovídat vašim potřebám; viz Jak hodnotit AI modely – benchmarky.
- Posuďte bezpečnost provozu: kde poběží, kdo má přístup, jak se aktualizuje.
- Zaveďte pravidla pro používání (firemní politika AI).
- Dokumentujte rozhodnutí: proč byl zvolen tento model a jaké zbytkové riziko zůstává. Dobrovolný rámec NIST pro řízení rizik AI doporučuje právě takový systematický přístup (NIST AI RMF).
Otevřenost jako spektrum
V praxi nejde o černobílý rozdíl. Mezi plně uzavřeným modelem dostupným jen přes cloudové rozhraní a modelem splňujícím OSAID existuje široké spektrum: model s otevřenými váhami a omezující licencí, model s otevřenými váhami a kódem bez informací o datech, model s úplnou dokumentací, ale bez povoleného komerčního použití. OSAID dává měřítko, podle kterého můžete vlastnosti posoudit, a pomáhá odlišit skutečnou otevřenost od marketingu. Při rozhodování nejde jen o to, zda je model „zdarma“, ale o to, co s ním smíte a co o něm víte.
Praktický příklad (smyšlený)
Studio chce použít model „otevřený“ podle reklamy pro generování textů klientům. Zjistí, že jsou zveřejněny jen váhy, ale ne informace o datech ani trénovací kód, a licence zakazuje určité komerční použití. Proto zvolí jiný model s licencí schválenou OSI a dokumentací dat, a dohodne se s právníkem na podmínkách. Příklad je smyšlený.
OSAID 1.0 požaduje čtyři svobody a tři složky: informace o datech, kód a parametry. Pouhé zveřejnění vah, známé jako open-weight, definici open source AI nesplňuje.
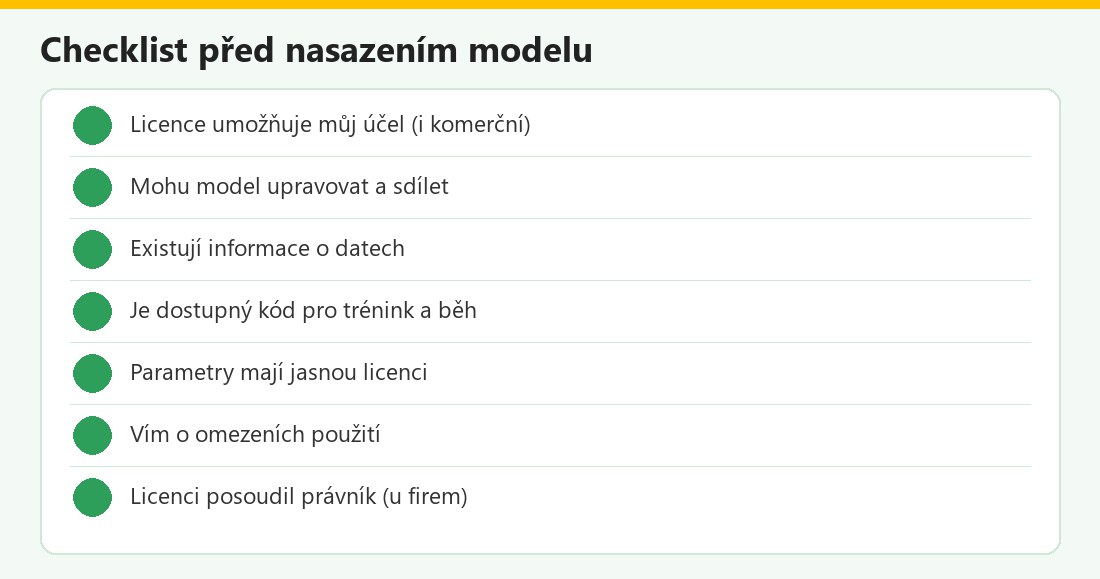 Kontrolní seznam – vlastní infografika
OSAID v kostce
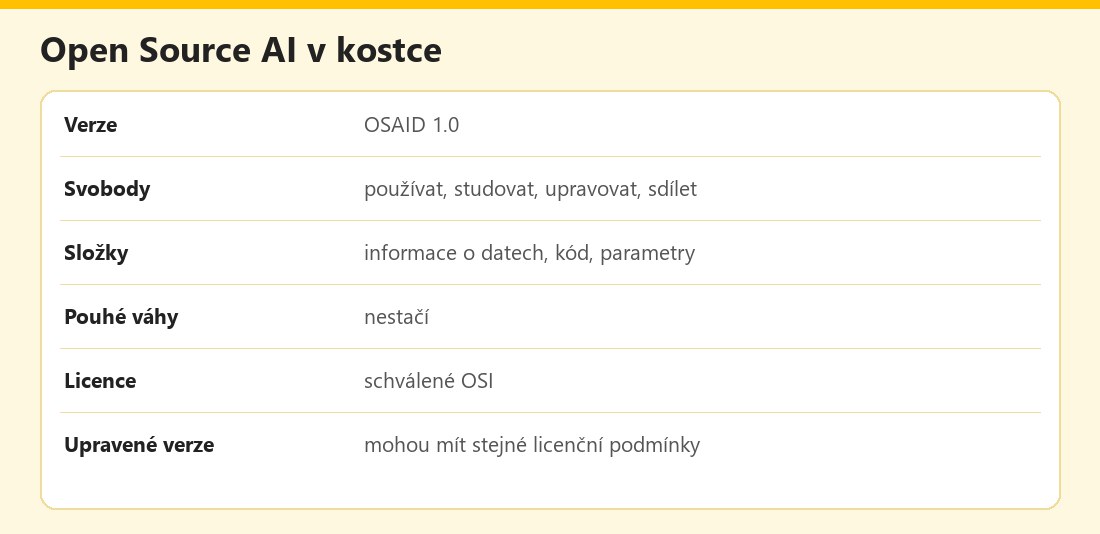 Základní údaje – vlastní infografika
Výhody a nevýhody
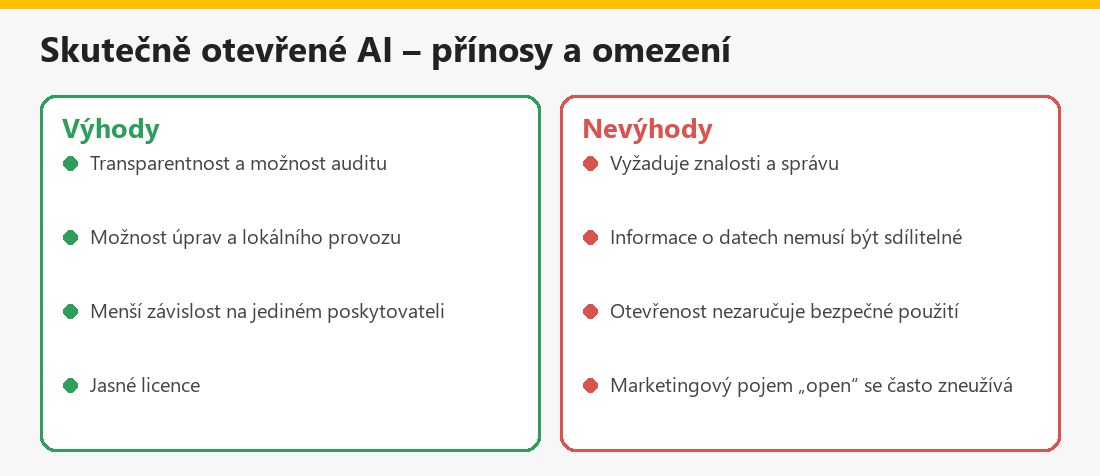 Souhrn – vlastní infografika
Související články
V kategorii Základy a principy AI najdete také Co je umělá inteligence a Slovník pojmů umělé inteligence.
Shrnutí
Podle Open Source AI Definition 1.0 (OSI) musí open source AI zaručit čtyři svobody (používat, studovat, upravovat, sdílet) a poskytnout informace o datech, kód a parametry pod licencemi schválenými OSI. Pouhé zveřejnění vah (open-weight) nestačí. Před nasazením zkontrolujte licenci, dostupnost kódu a dat a omezení použití. Nejde o právní poradenství.
Často kladené otázky k open-source AI
Co je OSAID?
Open Source AI Definition 1.0, definice organizace OSI, co znamená open source AI.
Jaké jsou čtyři svobody?
Používat, studovat, upravovat a sdílet systém k jakémukoli účelu.
Co musí open source model poskytnout?
Informace o datech, kód pro trénink a běh a parametry (váhy).
Je open-weight open source?
Ne, samotné zveřejnění vah definici nesplňuje.
Proč jsou důležité informace o datech?
Umožňují posoudit původ, zkreslení a reprodukovatelnost modelu.
Mohu „otevřený“ model použít komerčně?
Záleží na licenci; ověřte ji.
Je open source model bezpečnější?
Není automaticky; transparentnost pomáhá, ale otevřenost mohou zneužít i jiní.
Je to právní poradenství?
Ne, jde o obecné shrnutí.
