
Technické požadavky EMA na AI – data, validace, vysvětlitelnost, zmrazené modely a monitoring
Zatímco první část reflexního dokumentu EMA o AI v životním cyklu léčiv popisuje přístup podle rizika a fáze vývoje, druhá část se věnuje technickým požadavkům: jak mají vypadat data, jak se model testuje, jak se vysvětluje a sleduje a jak se chrání osobní údaje. Pro čtenáře mimo farmacii je to užitečný příklad toho, co znamená „důvěryhodná AI“ v praxi v oblasti s vysokými nároky. Tento článek shrnuje hlavní body dokumentu (konečná verze z 9. září 2024). Nejde o odborné ani právní poradenství.
Zdroj: EMA – Reflection paper on the use of AI in the medicinal product lifecycle (EMA/CHMP/CVMP/83833/2023, PDF). Navazuje na článek AI v životním cyklu léčiv – přístup podle rizika. Související: Model cards – dokumentace AI modelů.
Aktualizováno: listopad 2026.
Klíčové studie: zmrazené modely a prospektivní testování
U klinických studií, kde AI zpracovává data, platí přísná pravidla, zejména u klíčových (pivotních) studií:
- AI/ML modely se považují za součást statistické analýzy a musí splňovat pokyny pro statistické zásady klinických studií. U pozdní fáze vývoje se vyžaduje podrobný popis předem určeného postupu úpravy dat a zmrazený, zdokumentovaný (nebo EMA kvalifikovaný) soubor modelů ve statistickém plánu analýzy.
- Je nutné pečlivě omezit riziko přetrénování (overfittingu) a úniku dat (data leakage).
- Před nasazením modelu ve vysokém regulačním dopadu (například u primárního cílového ukazatele) se má výkon otestovat na prospektivně získaných datech (z budoucího kalendářního období) z prostředí či populace reprezentativní pro zamýšlený kontext.
- Inkrementální učení se nepřijímá; jakákoli změna modelu během studie vyžaduje regulační interakci.
- Před uzávěrkou databáze a odslepením mají být zpracování dat i všechny modely zmrazeny a zdokumentovány dohledatelně. Jakákoli nepředem stanovená úprava po otevření dat znamená, že výsledky jsou post hoc a nehodí se pro potvrzující důkaz.
- Doporučuje se zveřejnit modely v otevřeném úložišti před nasazením v klíčové studii, aby je mohly třetí strany přezkoumat.
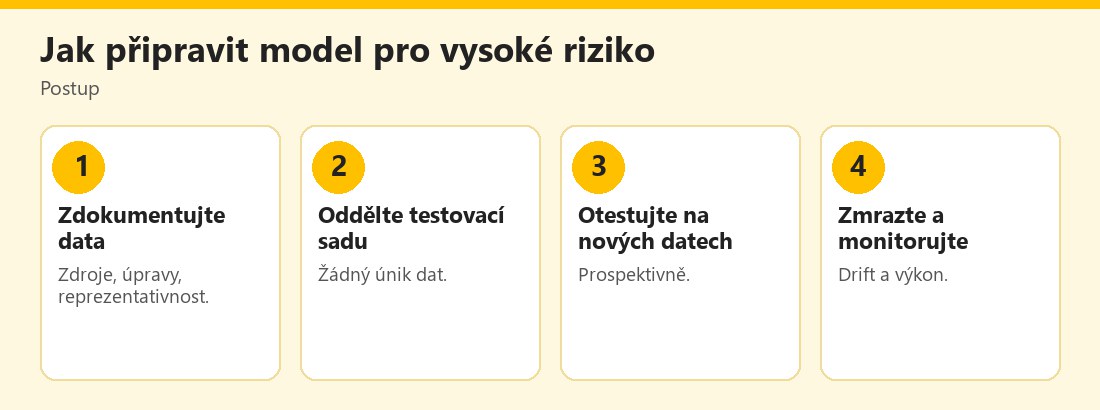 Postup přípravy modelu AI pro oblast s vysokým rizikem podle EMA – vlastní infografika
Data
Protože jsou modely řízeny daty, jsou náchylné k zabudování zkreslení. EMA očekává:
- vyvážený a dostatečně velký trénovací soubor vzhledem k zamýšlenému použití; zvážit je třeba i nadvzorkování vzácných populací s ohledem na zásadu nediskriminace,
- zdokumentování zdrojů a způsobu získání dat a všech úprav (čištění, transformace, imputace, anotace, normalizace, augmentace) dohledatelným způsobem v souladu s GxP,
- průzkumnou analýzu popisující vlastnosti, reprezentativnost, férovost a relevanci dat; minimálně zvážit relevanci a reprezentativnost, nevyváženost tříd a riziko nespravedlivých či diskriminačních výsledků,
- u augmentace (například geometrické úpravy obrazů či syntetická data) přiznat omezení; pokud omezení trénovacích dat zůstávají, mají být jasně uvedena v dokumentaci modelu spolu s doporučeními pro situace, kdy model není použitelný.
Trénovací, validační a testovací sady
EMA upozorňuje, že pojem validace se v AI/ML a ve vývoji léčiv používá různě. V AI/ML se validační data používají k výběru architektury a ladění hyperparametrů; konečný výkon se vyhodnocuje jednou na nezávislé testovací sadě. Pokud je výkon neuspokojivý, nelze stejnou testovací sadu znovu použít a je třeba zcela nová a nezávislá. Doporučuje se časné rozdělení na oddělené, nespojené soubory, ještě před normalizací či jiným zpracováním s agregovanými mírami. Přesto nelze přímý či nepřímý (často nechtěný) únik dat zcela vyloučit: například nezjištěné překryvy případů v klinických databázích či předchozí znalost výsledků studie. Proto mají být modely pro vysoké riziko prospektivně testovány na nově získaných datech.
Vývoj modelu a výkon
Sponzor odpovídá za to, aby standardní postupy podporovaly zobecnitelnost a robustnost modelů, zejména tam, kde nelze model během nasazení aktualizovat, a aby se vedla dohledatelná dokumentace a záznamy o vývoji. Pokud se v oblasti s vysokým dopadem používá model či služba třetí strany, očekává se, že výrobce poskytl podrobnosti prostřednictvím procesu kvalifikace metodiky pro daný kontext použití. Důležité je zamezit přetrénování (nejnebezpečnější příčinou je únik dat z testovací do trénovací sady) a jasně definovat zamýšlené použití. Při hodnocení výkonu doporučuje EMA metriky necitlivé na nevyváženost tříd, například Matthewsův korelační koeficient, prezentovat rozdělení metrik z křížové validace a provádět analýzy citlivosti pro menšinové třídy a v čase. Přínosné jsou předem stanovené prahové hodnoty výkonu podle úrovně rizika.
Interpretovatelnost a vysvětlitelnost
Pro zajištění procesní spravedlnosti, odpovědnosti a prevence zkreslení jsou preferovány transparentní modely. Nejvýkonnější architektury ale umožňují jen omezený vhled, proto lze „černé skříňky“ akceptovat tam, kde vývojáři doloží, že transparentní modely mají neuspokojivý výkon nebo robustnost. Použití musí podpořit zdůvodnění, podrobné informace o architektuře a ladění, metrikách a výsledcích validace a testování a předem definovaný plán monitoringu a řízení rizik. Takové aplikace se doporučuje konzultovat v rámci kvalifikace či vědeckého poradenství EMA. Pro přezkum a monitoring se mají používat metody vysvětlitelné AI, například analýzy SHAP a LIME, jak pro model, tak pro jednotlivé inference; u modelů počítačového vidění mapy aktivace či významnosti pro ověření, že vlastnosti jsou extrahovány z relevantních míst obrazu.
Nasazení a monitoring
U vysokého rizika pro pacienta a vysokého regulačního dopadu vyžaduje každá netriviální změna softwarového či hardwarového zázemí, včetně klíčových závislostí, nové vyhodnocení výkonu systému. Je třeba monitorovat výkon, aby se včas odhalil drift či zhoršení, a jasně definovat prahy přijatelného výkonu (například rutinní vzorkování dat pro ruční klasifikaci). Pro všechny modely, zejména ty bez člověka v řetězci, má vzniknout plán řízení rizik systému, který definuje pravděpodobné způsoby selhání, důsledky chybných predikcí, způsoby monitorování a nápravy a také jak pozastavit či vyřadit model.
Governance a ochrana osobních údajů
Standardní postupy pro správu dat a algoritmů mají zahrnovat všechna data, modely a algoritmy s vysokým dopadem či rizikem a mají být zdokumentovány a pravidelně přezkoumávány. EMA upozorňuje na nová, ne zcela popsaná rizika: modely mohou obsahovat podobnou úroveň podrobností o jednotlivcích jako trénovací data. Pokud byla pro trénink použita osobní data, je třeba posoudit, zda je lze reálně získat zpět pomocí útoků typu „membership inference“, „inference“ a „model inversion“. Velké jazykové modely jsou kvůli velikosti vystaveny riziku memorizace, které zvyšuje přetrénování; regularizace, vyřazování neuronů (dropout) a přidání náhodného šumu mohou podle implementace poskytnout částečnou až úplnou anonymizaci. Pokud trénovací data nelze sdílet, mají se před přesunem modelu do méně bezpečného prostředí použít opatření na anonymizaci. Při zpracování osobních údajů AI se doporučuje specifické posouzení rizik zaměřené na dopad na práva a svobody subjektů a na nezbytnost a přiměřenost, včetně zvážení použití anonymizovaných dat a zásady minimalizace.
Co z toho plyne pro firmy a výzkumníky
Následující body jsou úvahy autora článku:
- Oddělte testovací data od začátku a nikdy je nepoužívejte pro ladění.
- Dokumentujte celý řetězec od zdroje dat po verzi modelu.
- Měřte vhodnými metrikami, zvláště při nevyvážených třídách.
- Zmrazte model před vyhodnocením a nevydávejte „post hoc“ výsledky za potvrzující.
- Plánujte monitoring a zastavení. Model je třeba umět vypnout.
- Vysvětlujte výstupy, kde to jde, a jinak o to víc testujte.
- Chraňte data i model. Model může prozradit údaje, na kterých byl trénován.
Kde najít další informace
Další informace nabízí EMA a stránka EMA k reflexnímu dokumentu. Obecné zásady řízení rizik AI popisuje NIST AI Risk Management Framework, k rizikům aplikací s jazykovými modely, včetně uvolnění citlivých informací, slouží OWASP Top 10 pro LLM aplikace. K ochraně osobních údajů při používání AI modelů se vyjadřuje stanovisko 28/2024 Evropského sboru pro ochranu osobních údajů; viz také článek EDPB stanovisko 28/2024.
Proč jsou tyto požadavky užitečné i mimo farmacii
Většina popsaných zásad se dá přenést do jiných oborů: banky, pojišťovny, nemocnice či výrobní podniky se potýkají se stejnými otázkami. Únik dat do testovací sady způsobí, že model vypadá lépe, než ve skutečnosti je; nevyvážené třídy mohou zakrýt špatný výkon u vzácných, ale důležitých případů; model bez monitoringu se může tiše zhoršovat. Proto má smysl převzít několik jednoduchých návyků: oddělit testovací data hned na začátku, zapisovat verze dat a modelů, měřit výkon i v čase a mít předem rozhodnuto, kdo a kdy model zastaví. Tyto kroky nevyžadují drahé nástroje, jen disciplínu a ochotu přiznat omezení modelu.
Praktický příklad (smyšlený)
Tým vyvíjí model, který třídí snímky podle pravděpodobnosti nálezu. Testovací sadu oddělí hned na začátku a ověří, že se v ní nevyskytují pacienti z trénovací sady. Výkon měří Matthewsovým koeficientem a dokládá ho na nově získaných snímcích z jiného období. Model před konečným testem zmrazí a zdokumentuje, k výstupům přidá mapy významnosti a po nasazení sleduje drift. Příklad je smyšlený.
EMA očekává oddělené testovací sady, prospektivní testování na nových datech, zmrazené modely v klíčových studiích, monitoring driftu a plán pozastavení modelu. U modelů natrénovaných na osobních údajích je třeba posoudit riziko jejich zpětného získání.
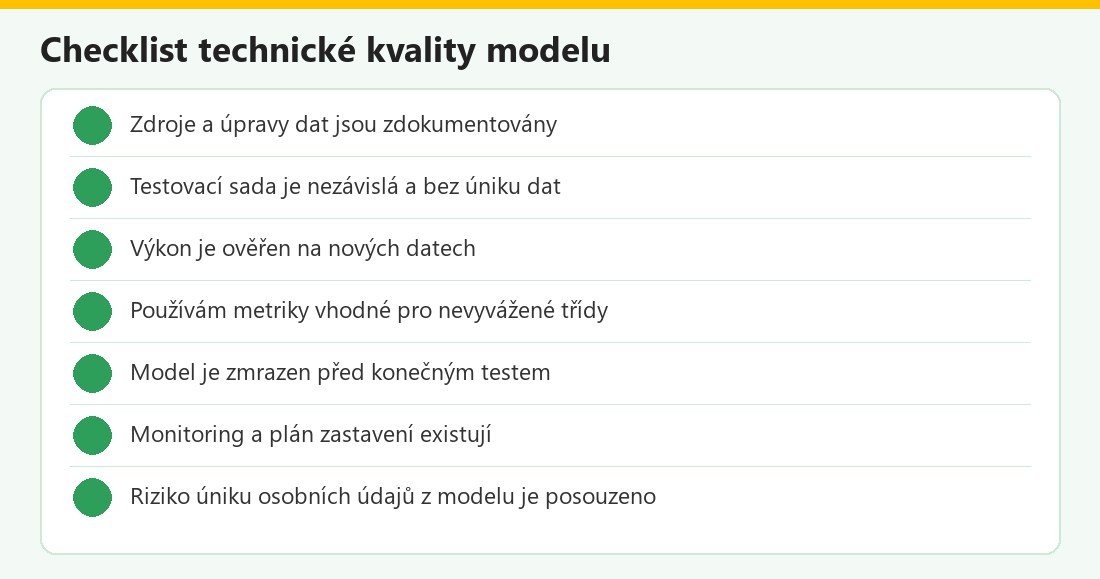 Kontrolní seznam – vlastní infografika
Technické požadavky v kostce
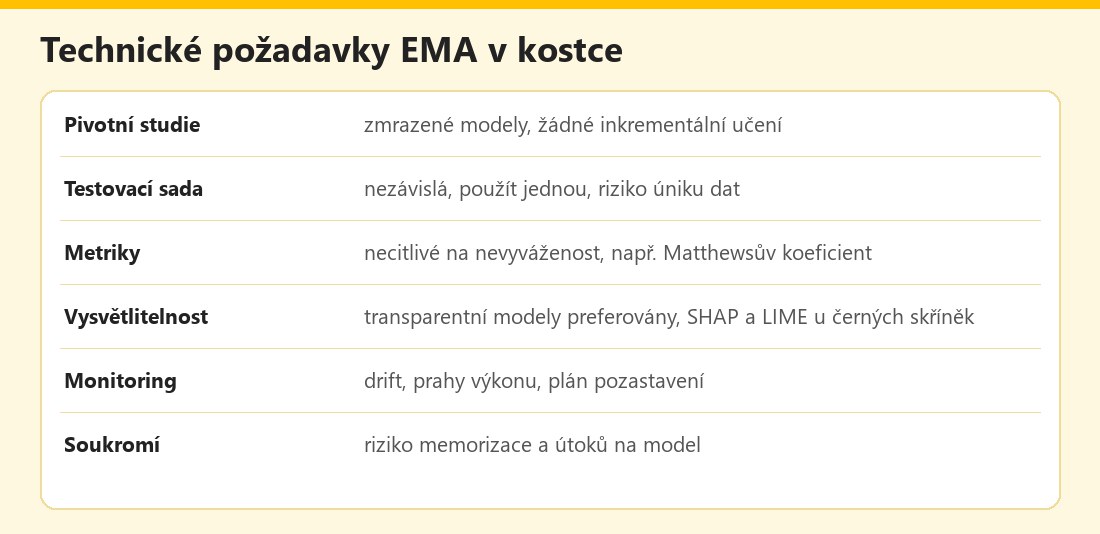 Základní údaje – vlastní infografika
Výhody a nevýhody
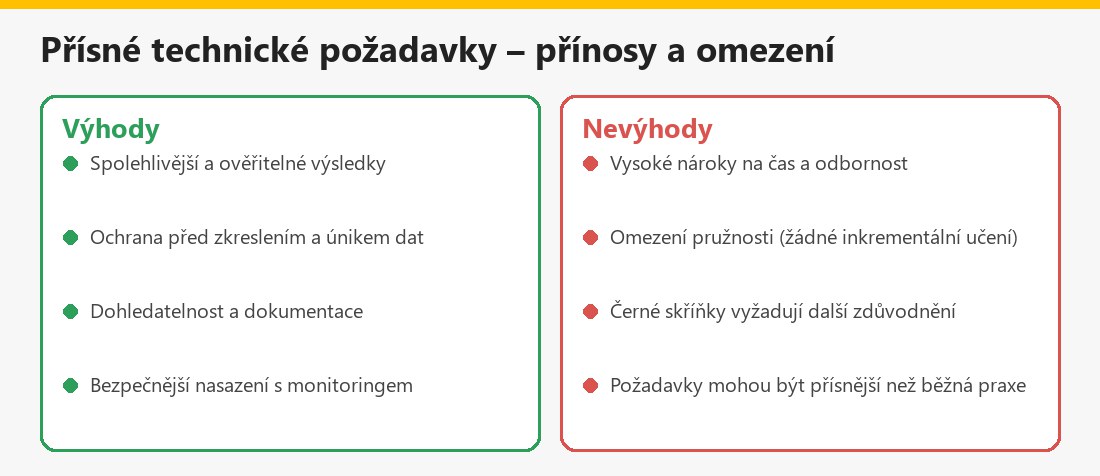 Souhrn – vlastní infografika
Související články
V kategorii AI v oborech najdete také AI v kybernetické obraně.
Shrnutí
EMA očekává u AI v regulovaných oblastech kvalitní a zdokumentovaná data, oddělené testovací sady, prospektivní testování, zmrazené modely v klíčových studiích a zákaz inkrementálního učení během studie, vhodné metriky, vysvětlitelnost u černých skříněk, monitoring driftu a plán zastavení. Upozorňuje také na riziko memorizace a útoků na model, které mohou odhalit osobní údaje. Je to dobrý příklad toho, co znamená důvěryhodná AI v praxi. Nejde o odborné ani právní poradenství.
Často kladené otázky k technickým požadavkům EMA
Co je únik dat?
Přímé či nepřímé šíření informací z testovací sady do vývojového prostředí modelu, které zvyšuje riziko přetrénování.
Může se model v klíčové studii učit za běhu?
Ne, inkrementální učení se nepřijímá; změna modelu vyžaduje regulační interakci.
Jaké metriky doporučuje EMA?
Metriky necitlivé na nevyváženost tříd, například Matthewsův korelační koeficient, a analýzy citlivosti.
Jsou černé skříňky povoleny?
Mohou být akceptovány, pokud vývojáři doloží, že transparentní modely mají nevyhovující výkon, a použijí metody vysvětlitelné AI.
Co je drift?
Zhoršení výkonu modelu v čase; má se monitorovat a mít definované prahy.
Může model prozradit osobní údaje?
Ano, EMA upozorňuje na útoky typu membership inference a model inversion a riziko memorizace u velkých jazykových modelů.
Je nutný plán zastavení?
Ano, pro všechny modely se doporučuje plán řízení rizik včetně pozastavení či vyřazení.
Je to odborné poradenství?
Ne, jde o shrnutí dokumentu.
