
Multimodální AI – jak modely rozumí textu, obrazu, zvuku a videu a na co si dát pozor
Starší chatboti uměli pracovat jen s textem. Dnešní modely stále častěji zvládají i obrázky, zvuk, dokumenty či video: vyfotíte jídelní lístek v cizím jazyce a model jej přeloží, nahrajete graf a požádáte o vysvětlení, namluvíte dotaz hlasem a dostanete hlasovou odpověď, nebo vložíte PDF s tabulkami. Taková schopnost se nazývá multimodalita a modely se označují jako multimodální. Rozšiřuje to využití AI, ale také rizika: obrázek nebo dokument může obsahovat citlivé údaje, model může nepřesně „vidět“ a v souboru se může ukrývat škodlivý pokyn (prompt injection). Pochopit, co multimodální AI umí a jak funguje, pomáhá používat ji účelně a bezpečně.
V tomto článku vysvětlujeme, co je modalita a multimodální model, jak může model „vidět“ a „slyšet“, jaké úlohy dnešní modely zvládají, jaká mají omezení, jak se liší nativně multimodální a skládané systémy, jaká jsou rizika pro soukromí a bezpečnost a jak soubory nahrávat bezpečně. Čerpáme z přehledů IBM: Multimodal AI, Google Cloud: Multimodal AI, z dokumentace Anthropic: Vision, Google Gemini: Image understanding, Gemini: Audio, Gemini: Video understanding a z práce CLIP: Learning Transferable Visual Models From Natural Language Supervision (anglicky). Nabídka modelů a jejich schopnosti se rychle mění; vždy ověřte aktuální stav v dokumentaci poskytovatele.
Další články najdete v kategorii Základy a principy AI, například Generativní AI vs. klasická AI, Tokeny a kontextové okno a Jak funguje umělá inteligence.
Aktualizováno: listopad 2026.
Co je modalita
Modalita je druh dat: text, obraz, zvuk (řeč, hudba), video, tabulky, kód, ale i data ze senzorů. Multimodální model dokáže přijímat více modalit (vstup) a často i vytvářet více modalit (výstup). Příklady:
- Text + obraz → text: popis fotografie, odpověď na otázku o obrázku, přečtení textu z paragonu či plakátu (OCR), vysvětlení grafu.
- Zvuk → text: přepis řeči; viz AI přepis řeči na text.
- Text → zvuk: syntéza řeči; viz AI text na řeč.
- Text → obraz / video / hudba: generativní modely; viz Porovnání AI generátorů obrázků a AI generování videa.
- Video → text: shrnutí videa, popis scény, odpovědi na otázky o obsahu.
- Hlasová konverzace: model slyší a odpovídá hlasem v reálném čase; viz Hlasový režim AI.
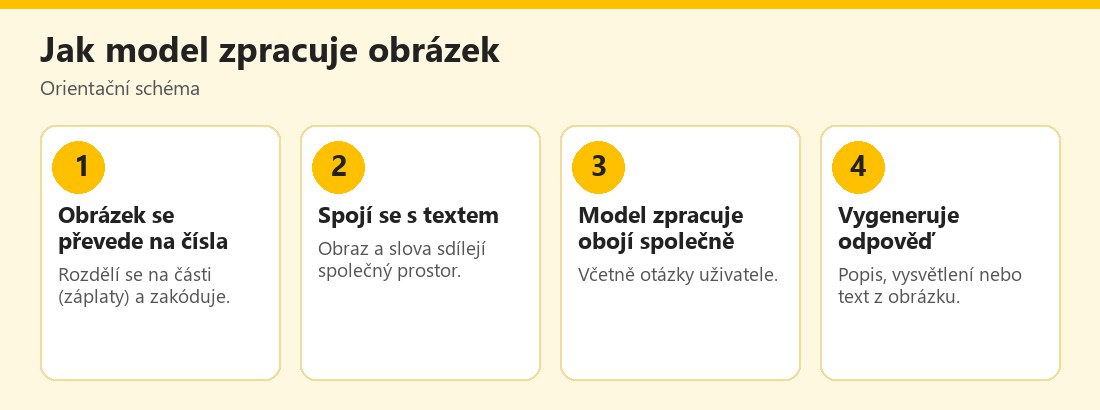 Orientační schéma zpracování obrázku multimodálním modelem – vlastní infografika
Jak model „vidí“ a „slyší“
Počítač nepracuje s fotografií, ale s čísly. Princip multimodálních modelů zjednodušeně:
- Kodér pro každou modalitu převede vstup (obrázek, zvuk) na číselnou reprezentaci (vektory, „tokeny“ obrazu či zvuku). Obrázek se obvykle rozdělí na malé části (záplaty), které se zakódují.
- Společný prostor: reprezentace různých modalit se sladí s textem, aby model mohl s obrázkem a slovem pracovat společně. Významnou ukázkou je přístup CLIP, který se na velkém množství dvojic „obrázek–popis“ naučil spojovat obraz a text.
- Jazykový model zpracuje tokeny textu i obrazu/zvuku v jednom kontextu a vygeneruje odpověď.
- Výstup může být text, a pokud model umí, také obrázek, zvuk či řeč.
Rozlišuje se nativně multimodální model (trénovaný od začátku na více modalitách) a skládaný systém (několik oddělených modelů propojených kódem: například samostatný přepis řeči, jazykový model a syntéza řeči). Nativní přístup bývá plynulejší a rychlejší (například u hlasových konverzací), skládaný bývá modulárnější a snáze kontrolovatelný. Videa se u některých modelů zpracovávají po snímcích, u jiných „nativně“ včetně zvuku; dokumentace poskytovatelů (například Gemini) popisuje, co přesně podporují. Obrázky, zvuk i video se v kontextovém okně převádějí na tokeny a spotřebují jej; viz Tokeny a kontextové okno.
K čemu se multimodální AI hodí
- Čtení a vysvětlení dokumentů: skeny, faktury, tabulky, grafy, rukopis (s omezenou spolehlivostí); viz dokumentace Anthropic Vision a Gemini Image understanding.
- Popis obrázků a přístupnost: pomoc nevidomým či slabozrakým; popisky fotografií.
- Překlad textu z fotografie (menu, cedule, návody).
- Práce s grafy a diagramy: vysvětlení, extrakce čísel.
- Pomoc při studiu: vyfotografovaná úloha → vysvětlení postupu; viz AI tutoři a personalizované vzdělávání.
- Rozpoznání rostlin, objektů, závad (orientačně).
- Zvukové úlohy: přepis schůzek, shrnutí podcastů, hlasový asistent; viz Gemini Audio.
- Analýza videa: shrnutí přednášky, vyhledání momentů, popis dění.
- Tvůrčí práce: generování a úpravy obrázků a videa; viz AI pro fotografii a úpravu obrázků.
- Kombinované asistenty: např. „podívej se na fotku ledničky a navrhni recept“; viz AI pro vaření a recepty.
Model může obsah obrázku popsat chybně nebo si „domyslet“ detaily, které tam nejsou, zejména u malého textu, složitých grafů, rukopisu, rentgenů či podobných obrázků. U zdravotních, právních a finančních informací ho proto berte jen jako pomůcku a výsledek ověřte u odborníka.
Omezení a chyby
- Halucinace u obrázků: model může popsat objekty, které na obrázku nejsou, nebo zaměnit podobné věci; viz Proč AI halucinuje.
- Malý text, špatná kvalita, nezvyklé úhly snižují spolehlivost; zkontrolujte přepsaná čísla a jména.
- Prostorové uvažování a počítání: modely často chybují v počtu předmětů, přesných pozicích, měřítku či orientaci.
- Grafy a tabulky: hodnoty lze přečíst nepřesně; vždy ověřte klíčová čísla.
- Rukopis a méně obvyklé jazyky mívají vyšší chybovost.
- Zdravotní snímky a odborné obrazové úlohy: obecné modely nejsou certifikovanými pomůckami; viz AI ve zdravotnictví.
- Zvuk: přepis může chybovat při šumu, dialektech, odborných termínech či překrývajících se mluvčích.
- Video: delší záznamy se zpracovávají po snímcích či s omezenou délkou; detaily mohou unikat.
- Limity velikosti a počtu souborů a omezení délky výstupu.
- Zkreslení: rozpoznávání lidí a situací může být zkreslené; viz Rizika AI: bias a diskriminace.
- Rozpoznání osob: služby často z bezpečnostních důvodů identifikaci osob podle obličeje omezují.
Soukromí a bezpečnost při nahrávání souborů
Nahrávání fotografií a dokumentů znamená, že data odcházejí do služby poskytovatele. Na co dbát:
- Citlivé obsahy: doklady, smlouvy, výsledky vyšetření, firemní data, fotografie dětí a cizích osob; nenahrávejte je bez znalosti pravidel poskytovatele a bez nutnosti; viz Únik dat do AI chatbotů a AI chatboti a soukromí dat.
- Použití k trénování: zjistěte v nastavení, zda lze zapnout vypnutí použití vašich dat k zlepšování modelů; viz Paměť a nastavení soukromí v ChatGPT.
- Metadata fotografií: poloha, čas a zařízení; před sdílením zvažte jejich odstranění.
- Údaje třetích osob: spolužáci, kolegové, zákazníci; mohou se vztahovat povinnosti ochrany osobních údajů; viz AI a ochrana osobních údajů (GDPR).
- Prompt injection v souborech: obrázek či dokument může obsahovat skrytý či viditelný text s pokyny („ignoruj předchozí instrukce…“), který se model pokusí splnit; viz Prompt injection. Nedůvěřujte souborům z neznámých zdrojů a u agentů s přístupem k nástrojům buďte opatrní.
- Deepfake a podvrhy: modely mohou vytvářet věrohodné falešné obrázky, hlasy a videa; viz Deepfake: jak poznat a Klonování hlasu pomocí AI.
- Autorská práva: nahrávání cizích děl a výstupy; viz Etika AI a autorská práva.
- Hlasové konverzace: zvuk se může zaznamenávat; v nastavení zkontrolujte uchovávání a vypnutí zápisu.
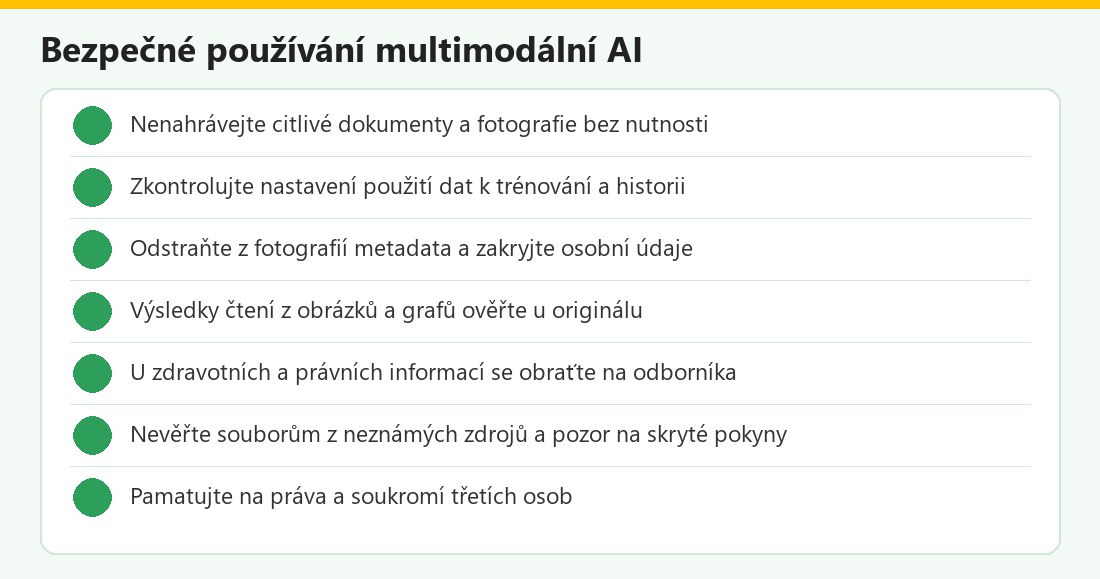 Kontrolní seznam – vlastní infografika
Jak vybrat a jak začít
- Co potřebuji: čtení dokumentů, popis fotek, zvuk či video? Každý model má silné stránky; porovnání chatbotů najdete v ChatGPT vs Gemini vs Claude.
- Zkuste vlastní příklady a ověřte přesnost na úlohách, které znáte.
- Zadání upřesněte: „přečti text z obrázku a vypiš ho doslova“, „popiš jen to, co vidíš, nic nedomýšlej“, „uveď, kde si nejsi jistý“.
- Kvalita vstupu: ostrý, dobře osvětlený obrázek, nezkreslený úhel, celý dokument.
- Dělení úloh: velké dokumenty rozdělte, ověřujte po částech.
- Zálohy a ověření: důležité údaje porovnejte s originálem.
- Lokální modely (pro citlivá data) jsou možnost; viz Lokální AI doma: Ollama.
- Zadání pro přístupnost: vyzkoušejte popisy obrázků pro lidi se zrakovým postižením, ale kontrolujte přesnost.
Firmy a organizace
Firmy využívají multimodální AI pro zpracování faktur a formulářů, kontrolu kvality, přepis hovorů, analýzu videa a zákaznickou podporu. Důležité je mít pravidla (jaká data smějí do služeb), posoudit dodavatele, ověřovat přesnost, chránit osobní údaje a obchodní tajemství, řešit bezpečnost vůči prompt injection a zachovat lidský dohled; viz Firemní politika používání AI a AI v práci. Při použití kamer a rozpoznávání osob platí přísná pravidla (viz Kamery a rozpoznávání obličeje ve městech a EU AI Act).
Časté otázky v praxi
Umí chatbot přečíst fotografii?: většina současných modelů ano, ale s chybami; důležité údaje ověřte. Je bezpečné nahrát doklad?: raději ne, bez nutnosti a znalosti pravidel. Rozumí video?: některé modely ano, často po snímcích a s omezením délky. Mohu mu věřit u grafů?: orientačně; čísla kontrolujte. Proč popsal něco, co tam není?: halucinace u obrázků.
Multimodální AI v kostce
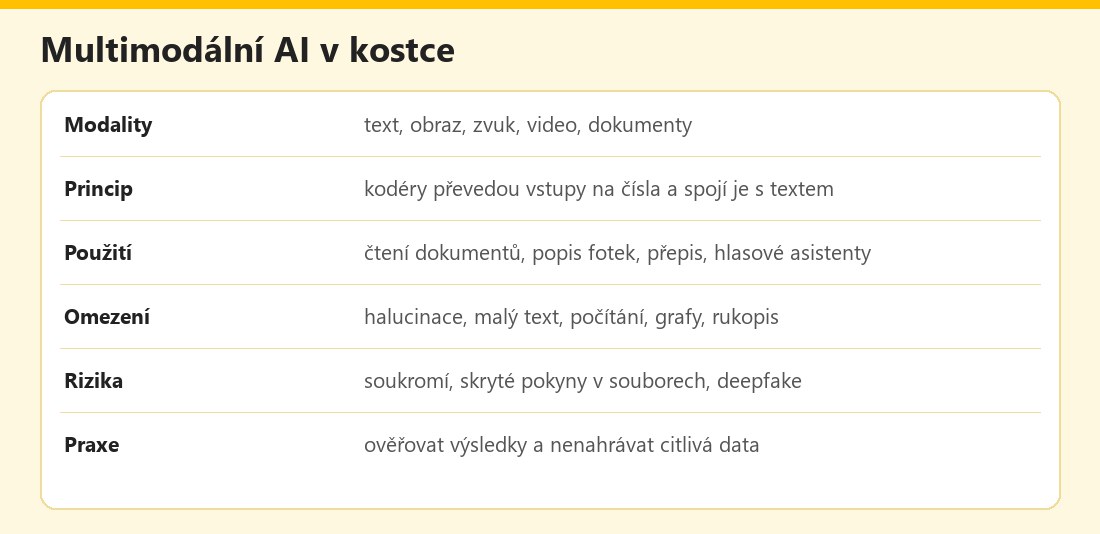 Základní údaje – vlastní infografika
Výhody a nevýhody
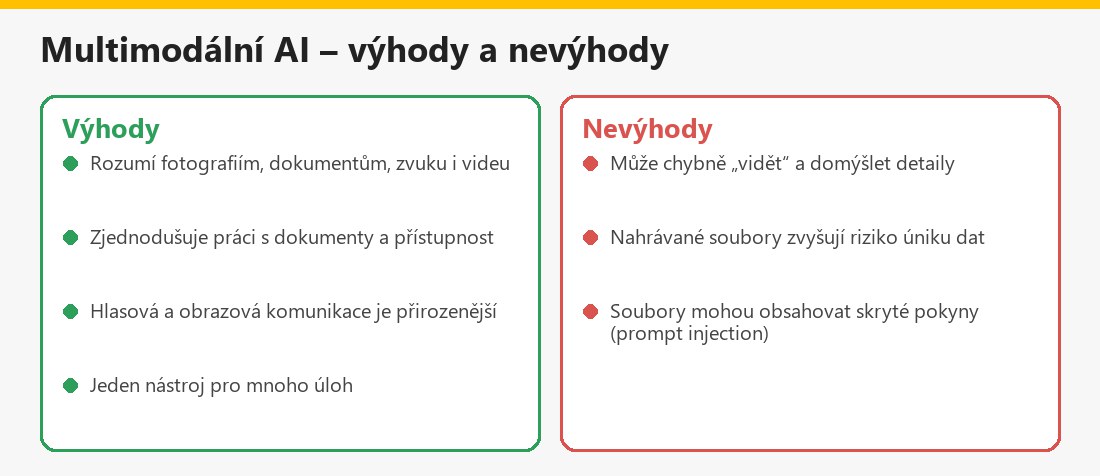 Souhrn pro uživatele – vlastní infografika
Související články
Další články najdete v kategorii Základy a principy AI: Jak hodnotit AI modely, RAG a fine-tuning, Historie umělé inteligence a Slovník pojmů umělé inteligence.
Shrnutí
Multimodální AI zpracovává více druhů dat, například text, obraz, zvuk a video. Hodí se pro čtení dokumentů, popis fotek, přepis a hlasové asistenty, ale může chybně „vidět“ a domýšlet detaily. Důležitá čísla a zdravotní či právní informace ověřujte, nenahrávejte citlivé soubory bez znalosti pravidel a pozor na skryté pokyny v souborech. Více najdete v přehledu IBM.
Často kladené otázky k multimodální AI
Co je multimodální AI?
Model, který dokáže zpracovávat více druhů dat najednou, například text, obrázky, zvuk a video.
Jak model vidí obrázek?
Obrázek se převede na číselnou reprezentaci, spojí se s textem a zpracuje společně s dotazem.
K čemu se hodí?
Ke čtení dokumentů a grafů, popisu fotek, přepisu zvuku, shrnutí videa a hlasovým asistentům.
Může halucinovat u obrázků?
Ano; může popsat objekty, které tam nejsou, nebo špatně přečíst malý text a čísla.
Je bezpečné nahrávat doklady?
Raději ne, bez nutnosti a znalosti pravidel poskytovatele; zkontrolujte nastavení soukromí.
Co je prompt injection v obrázku?
Skrytý či viditelný text s pokyny, který se model pokusí splnit; nedůvěřujte souborům z neznámých zdrojů.
Rozumí model videu?
Některé ano, často po snímcích a s omezením délky; detaily mohou unikat.
Jak zlepšit výsledky?
Dát kvalitní vstup, přesné zadání, ověřovat klíčové údaje a dělit velké úlohy.
