
Stanovisko EDPB 28/2024 – osobní údaje a AI modely: anonymita modelu a oprávněný zájem
Jazykové modely se učí z obrovského množství textů, které často obsahují osobní údaje: jména, e-maily, příspěvky na sítích. Smí je poskytovatelé použít? Dá se model považovat za anonymní, i když byl takovými daty trénován? A co když byla data původně zpracována nezákonně? Na tyto otázky odpovídá Evropský sbor pro ochranu osobních údajů (EDPB) ve stanovisku 28/2024, které vzniklo na žádost irského dozorového úřadu. Tento článek shrnuje jeho hlavní závěry srozumitelně a bez právnického žargonu.
Informace vycházejí ze stanoviska EDPB 28/2024 o některých aspektech ochrany osobních údajů v souvislosti se zpracováním osobních údajů v kontextu modelů AI (přijato 17. 12. 2024; stránka stanoviska, PDF); stránka uvádí též související pokyny k oprávněnému zájmu a další dokumenty. Stanovisko je určeno dozorovým úřadům a vysvětluje, jak mají posuzovat konkrétní případy; neposkytuje jednoznačné „ano či ne“. Nejde o právní poradenství.
Související články: AI a ochrana osobních údajů (GDPR), Únik dat do AI chatbotů a Model cards.
Aktualizováno: listopad 2026.
Čtyři otázky, na které stanovisko odpovídá
Irský úřad se ptal na zpracování osobních údajů ve vývoji i nasazení modelů AI:
- Kdy a jak lze model AI považovat za „anonymní“?
- Jak mohou správci prokázat, že je oprávněný zájem vhodným právním základem při vývoji modelu?
- …a při nasazení modelu?
- Jaké jsou důsledky nezákonného zpracování osobních údajů ve fázi vývoje na následné zpracování či provoz modelu?
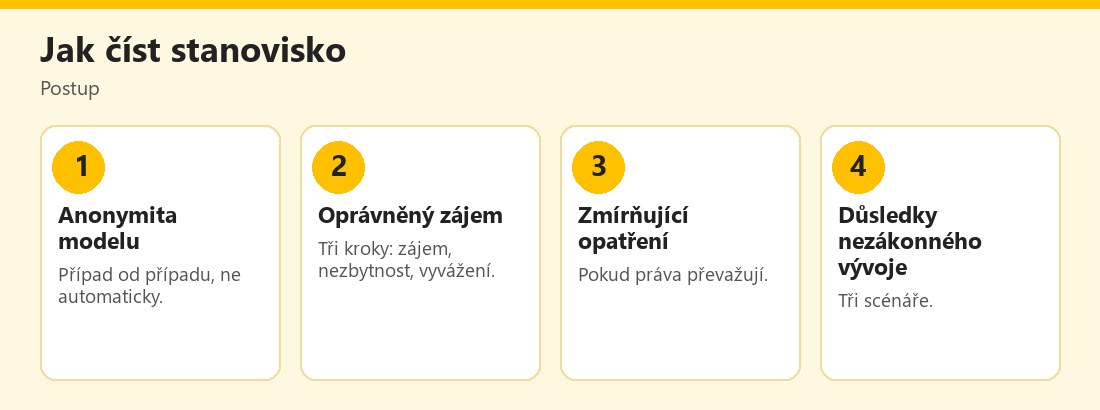 Postup čtení stanoviska EDPB 28/2024 – vlastní infografika
1. Kdy je model anonymní
EDPB uvádí, že tvrzení o anonymitě modelu AI mají dozorové úřady posuzovat případ od případu, protože modely trénované na osobních údajích nelze ve všech případech považovat za anonymní. Aby byl model anonymní, musí být nevýznamná jak:
- pravděpodobnost přímé (včetně pravděpodobnostní) extrakce osobních údajů osob, jejichž údaje byly při vývoji použity,
- tak pravděpodobnost získání takových údajů z dotazů (záměrně či náhodou),
přičemž se berou v úvahu „všechny prostředky, které lze rozumně očekávat, že budou použity“ správcem či jinou osobou.
Dozorové úřady mají posoudit dokumentaci, kterou správce k prokázání anonymity předloží. Stanovisko uvádí nezávazný a neúplný seznam metod: například přístupy při vývoji, které předcházejí či omezují sběr osobních údajů pro trénink, snižují možnost identifikace, brání extrakci nebo poskytují záruky odolnosti vůči útokům na úrovni současného stavu techniky.
Pro uživatele z toho plyne: tvrzení „model je anonymní“ není automaticky pravdivé. Pokud model dokáže vyprodukovat osobní údaje z tréninkových dat, GDPR se na něj může vztahovat.
2. a 3. Oprávněný zájem při vývoji a nasazení
EDPB připomíná, že mezi právními základy GDPR neexistuje hierarchie a je na správci, aby zvolil vhodný. Pro oprávněný zájem platí třístupňový test:
- Identifikace oprávněného zájmu (správce či třetí strany).
- Test nezbytnosti: lze zájem sledovat zpracováním, a neexistuje méně zasahující způsob? Zvláštní pozornost se věnuje množství zpracovávaných údajů a minimalizaci.
- Test vyvážení: zájem nesmí být převážen zájmy či základními právy a svobodami subjektů údajů.
Krok 1: zájem je oprávněný, pokud je zákonný, jasně a přesně formulovaný a skutečný a současný (ne spekulativní). Příklady z textu: při vývoji konverzačního agenta, který pomáhá uživatelům; při nasazení zlepšení detekce hrozeb v informačním systému.
Krok 2: posuzuje se, zda zpracování umožní sledovat zájem a zda neexistuje méně invazivní cesta, s ohledem na proporcionalitu a minimalizaci.
Krok 3: test vyvážení se provádí s ohledem na konkrétní okolnosti. EDPB upozorňuje na specifická rizika pro základní práva ve fázi vývoje i nasazení a na to, že dopady mohou být pozitivní i negativní; úřady zohledňují povahu údajů, kontext a možné další důsledky.
Rozumná očekávání lidí
Důležitou roli v testu vyvážení hrají rozumná očekávání subjektů údajů. Protože jsou technologie AI složité a lidé mohou těžko pochopit možná použití a různé činnosti zpracování, hodnotí se:
- informace poskytnuté subjektům údajů,
- kontext zpracování: zda byly údaje veřejně dostupné, vztah mezi osobou a správcem, povaha služby, kontext sběru, zdroj (web či služba a jejich nastavení soukromí), možná další použití modelu a zda si lidé vůbec uvědomují, že jsou jejich údaje online.
Zmírňující opatření
Pokud se zdá, že zájmy a práva osob převažují nad oprávněným zájmem, správce může zvážit zmírňující opatření, která omezí dopady. Nesmí se zaměňovat s opatřeními, která musí správce přijmout tak či tak pro soulad s GDPR. Opatření mají být šitá na míru okolnostem a modelu, včetně zamýšleného použití. Stanovisko uvádí neúplný seznam příkladů pro fázi vývoje (včetně web scrapingu) i nasazení; zdůrazňuje, že se rychle vyvíjejí a hodnotí je dozorové úřady případ od případu.
4. Důsledky nezákonného vývoje: tři scénáře
EDPB nejprve připomíná, že dozorové úřady mají diskreční pravomoc posoudit porušení a zvolit přiměřená opatření. Poté probírá tři scénáře:
- Scénář 1: osobní údaje zůstaly v modelu (model není anonymní) a zpracovává je stejný správce při nasazení. Zda vývoj a nasazení představují oddělené účely, a jak chybějící právní základ u prvního zpracování ovlivní zákonnost následného, se posuzuje případ od případu.
- Scénář 2: údaje zůstaly v modelu a zpracovává je jiný správce při nasazení. Dozorové úřady mají zohlednit, zda správce nasazující model provedl vhodné posouzení (v rámci odpovědnosti), že model nebyl vyvinut nezákonným zpracováním osobních údajů. Zohlední se například zdroj údajů a zda bylo zpracování při vývoji předmětem zjištěného porušení (zejména úřadem či soudem); míra podrobnosti posouzení závisí na rizicích nasazení.
- Scénář 3: správce nezákonně zpracoval údaje při vývoji, ale poté model zcela anonymizoval, a až pak začíná další zpracování. Pokud lze prokázat, že provoz modelu nezahrnuje zpracování osobních údajů, GDPR se na něj nevztahuje a nezákonnost původního zpracování neovlivní následný provoz. Zpracování osobních údajů shromážděných při nasazení po anonymizaci ale GDPR podléhá a jeho zákonnost nemá být ovlivněna původní nezákonností.
Co z toho plyne pro uživatele
- Nepředpokládejte, že model je „bez osobních údajů“. Může obsahovat či vyprodukovat osobní údaje; nezadávejte do chatu citlivá data o sobě ani o druhých.
- Máte práva podle GDPR, například na informace o zpracování; viz GDPR – žádost o přístup a obecné informace Úřadu pro ochranu osobních údajů.
- Čtěte nastavení soukromí a možnosti vypnout použití dat k trénování; viz Gemini a soukromí.
- Veřejně dostupné neznamená volně použitelné. Rozumná očekávání lidí jsou jedním z kritérií.
Co z toho plyne pro firmy
- Určete právní základ pro každou fázi (vývoj, nasazení) a zdokumentujte test oprávněného zájmu.
- Minimalizujte osobní údaje: nesbírejte více, než je nutné; zvažte filtrování a anonymizaci.
- Posuďte, zda je model anonymní, a vedte dokumentaci důkazů (testy extrakce, odolnost vůči útokům).
- Informujte lidi o zpracování a zohledněte jejich rozumná očekávání.
- Zaveďte zmírňující opatření, pokud práva osob převažují.
- Při používání cizího modelu ověřte jeho původ a zákonnost vývoje, a to přiměřeně rizikům nasazení; viz Dodavatelský řetězec AI.
- Konzultujte pověřence a právníka a sledujte vývoj výkladu.
Další zdroje
Souvislosti s řízením rizik AI nabízí rámec NIST AI RMF, který mezi vlastnostmi důvěryhodné AI uvádí také ochranu soukromí (normy a postupy chránící autonomii, identitu a důstojnost lidí). Pro ověření původu a vlastností modelů je užitečná definice Open Source AI Definition s požadavkem na informace o trénovacích datech. Rizika spojená s únikem informací z modelů a aplikací popisuje OWASP v přehledu Top 10 for LLM Applications (například „Sensitive Information Disclosure“).
Praktické otázky, které si klást
Jako uživatel: Používá služba moje chaty k trénování? Mohu to vypnout? Jak dlouho se data uchovávají? Kdo je správcem? Mohu požádat o výmaz? Jako firma: Mají trénovací data právní základ? Provedli jsme test oprávněného zájmu a posouzení dopadů? Je model anonymní, nebo se může stát, že vyprodukuje osobní údaje? Jak se vypořádáme s žádostmi subjektů údajů o přístup či výmaz, pokud model obsahuje osobní údaje? Máme smlouvy s dodavateli? Jak zajistíme minimalizaci a bezpečnost? Jako škola či úřad: Jaká data zpracováváme, komu je předáváme a na jakém základě? Jak informujeme žáky a rodiče?
Poznámka k českému kontextu
Stanovisko je určeno dozorovým úřadům v celé EU a vysvětluje společný výklad GDPR. V České republice je dozorovým úřadem Úřad pro ochranu osobních údajů, na jehož stránkách najdete obecné informace o ochraně osobních údajů; pro konkrétní případy je vhodné obrátit se na pověřence pro ochranu osobních údajů či právníka. Evropské nařízení o AI (AI Act) se uplatňuje souběžně a doplňuje pravidla GDPR; viz AI Act – harmonogram.
Praktický příklad (smyšlený)
Firma chce nasadit cizí jazykový model pro zákaznickou podporu. Požádá dodavatele o dokumentaci: odkud pocházela trénovací data, jak se řešily osobní údaje, zda byl proveden test oprávněného zájmu a zda je model anonymní. Dodavatel předloží shrnutí a testy odolnosti proti extrakci. Firma si výsledky zaznamená do posouzení rizik a do modelu nevkládá osobní údaje zákazníků, které nejsou nezbytné. Příklad je smyšlený.
Podle EDPB nejsou modely trénované na osobních údajích vždy anonymní: anonymita se posuzuje případ od případu a musí být nevýznamná pravděpodobnost extrakce i získání údajů z dotazů. Oprávněný zájem vyžaduje třístupňový test včetně rozumných očekávání lidí.
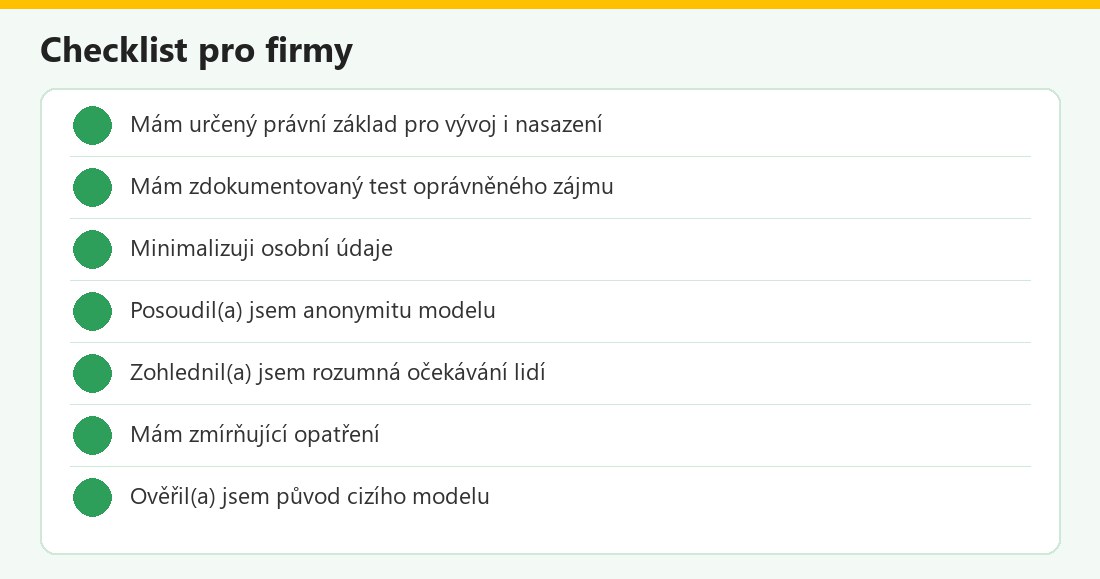 Kontrolní seznam – vlastní infografika
Stanovisko v kostce
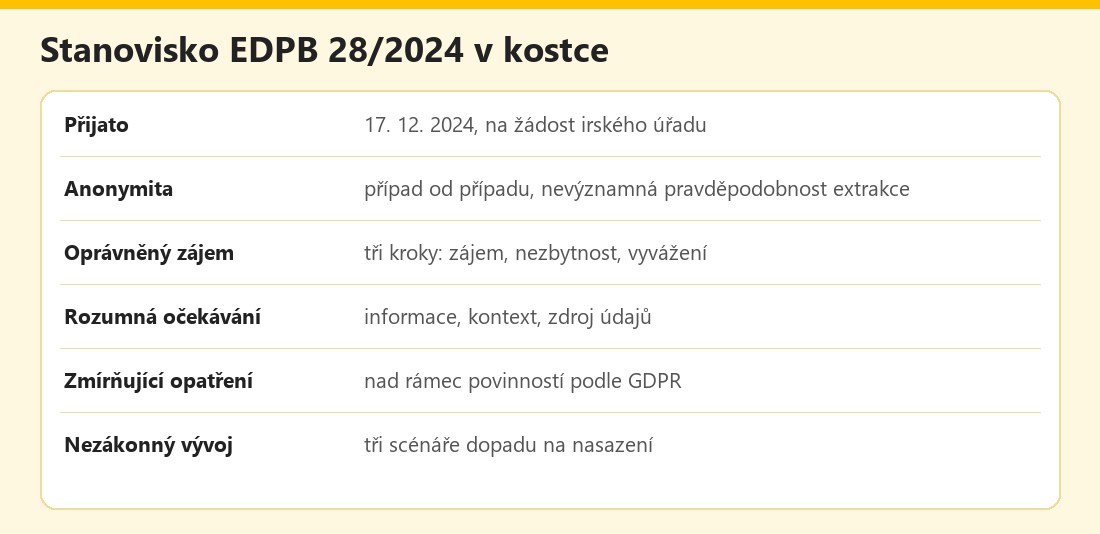 Základní údaje – vlastní infografika
Výhody a nevýhody
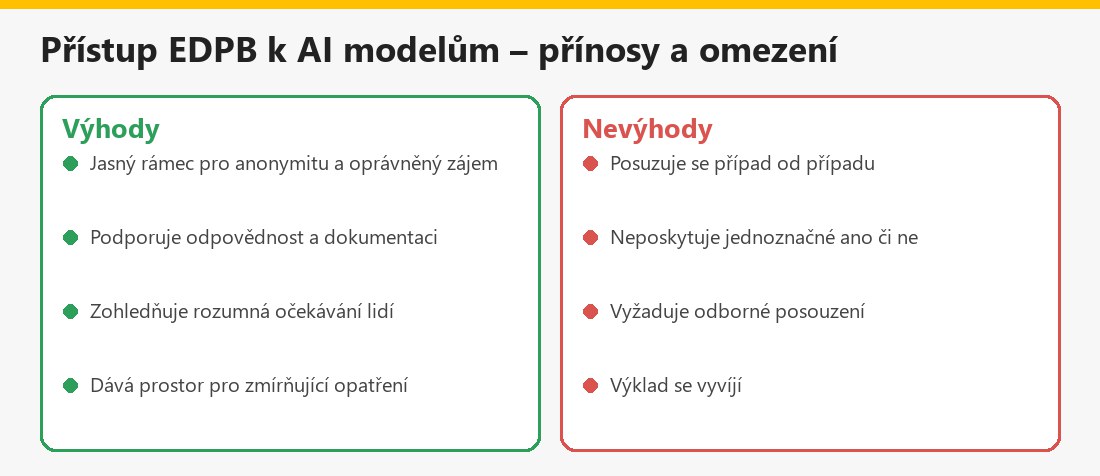 Souhrn – vlastní infografika
Související články
V kategorii Bezpečnost, etika a rizika AI najdete také Etika AI a autorská práva a Rizika AI – bias a diskriminace.
Shrnutí
Stanovisko EDPB 28/2024 říká, že model AI trénovaný na osobních údajích není vždy anonymní: anonymita se posuzuje případ od případu a musí být nevýznamná pravděpodobnost extrakce i získání údajů z dotazů. Pro oprávněný zájem platí třístupňový test (zájem, nezbytnost, vyvážení) s důrazem na rozumná očekávání lidí a zmírňující opatření. Důsledky nezákonného vývoje pro nasazení se liší podle tří scénářů. Nejde o právní poradenství.
Často kladené otázky ke stanovisku EDPB 28/2024
Je model AI vždy anonymní?
Ne, modely trénované na osobních údajích nelze vždy považovat za anonymní; posuzuje se případ od případu.
Kdy je anonymní?
Pokud je nevýznamná pravděpodobnost přímé extrakce údajů i jejich získání z dotazů, s ohledem na všechny rozumně použitelné prostředky.
Jaký je test oprávněného zájmu?
Tři kroky: identifikace zájmu, test nezbytnosti a test vyvážení.
Co jsou rozumná očekávání?
Co mohou lidé rozumně očekávat s ohledem na informace, kontext a zdroj údajů.
Co jsou zmírňující opatření?
Opatření nad rámec povinností GDPR, která snižují dopad zpracování na lidi.
Ovlivní nezákonný vývoj provoz modelu?
Závisí na scénáři; u prokazatelně anonymního modelu se GDPR na jeho provoz nevztahuje.
Pro koho je stanovisko určeno?
Pro dozorové úřady, ale pomáhá i správcům.
Je to právní poradenství?
Ne, jde o obecné shrnutí.
