
Kolaps modelu (model collapse) – co se stane, když se AI učí z textů vytvořených jinou AI
Internet se plní texty, obrázky a videi, které vytvořila umělá inteligence. Přitom právě z internetu se další generace jazykových modelů učí. Co se stane, když AI trénujeme na datech, která vytvořila jiná AI? Odpověď nabízí vědecká studie „The Curse of Recursion: Training on Generated Data Makes Models Forget“ (Shumailov a kol., 2023). Autoři popisují jev model collapse (kolaps modelu): modely postupně zapomínají skutečné rozdělení dat. Tento článek vysvětluje, co to znamená, jak to autoři ukázali a co z toho plyne pro budoucnost AI i pro uživatele.
Informace vycházejí z abstraktu a plného textu studie na arXiv:2305.17493 (autoři Ilia Shumailov, Zakhar Shumaylov, Yiren Zhao, Yarin Gal, Nicolas Papernot a Ross Anderson; první verze 27. 5. 2023, aktuální verze z 14. 4. 2024). Uvedené experimenty byly provedeny na menších modelech a jednoduchých rozděleních; jde o proof-of-concept, nikoli o předpověď chování konkrétních komerčních modelů. Nejde o odborné poradenství.
Související články: Jak se trénuje AI model, Značení AI obsahu – watermarking a C2PA a Dezinformace a AI propaganda.
Aktualizováno: listopad 2026.
O co jde
Studie se ptá: co se stane s modely typu GPT-n, až velkou část jazyka na internetu vytvoří samotné jazykové modely? Autoři zjistili, že použití obsahu vytvořeného modelem při tréninku způsobuje nevratné vady výsledných modelů, přičemž mizí „ocasy“ původního rozdělení obsahu, tedy vzácné, málo pravděpodobné jevy. Tento efekt nazvali model collapse a ukázali ho u variačních autoenkodérů, Gaussovských směsných modelů i velkých jazykových modelů. Zároveň varují, že hodnota dat o skutečných lidských interakcích se bude při přítomnosti obsahu generovaného LLM v datech sesbíraných z internetu zvyšovat.
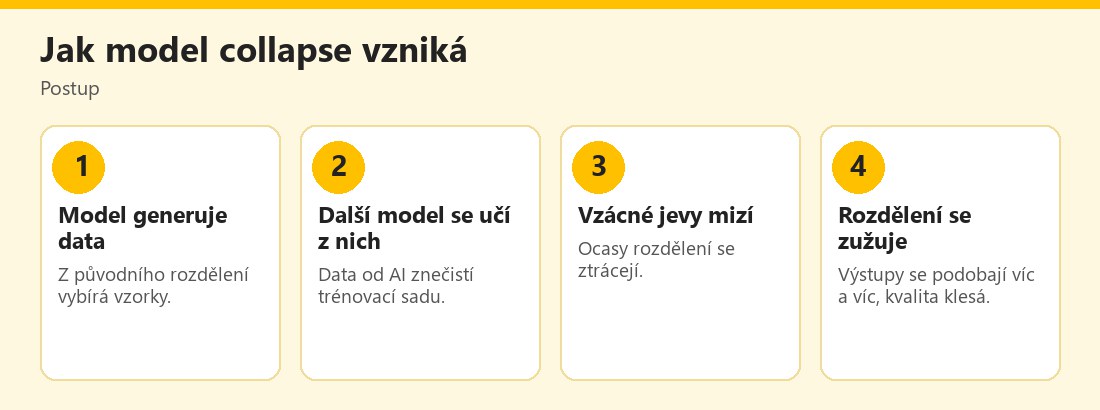 Postup vzniku kolapsu modelu – vlastní infografika
Definice: raný a pozdní kolaps
Podle studie je model collapse degenerativní proces, při kterém vygenerovaná data znečistí trénovací sadu další generace modelů; ty pak špatně vnímají realitu. Autoři rozlišují dva případy:
- Raný kolaps (early model collapse): model začíná ztrácet informace o ocasech rozdělení, tedy o vzácných jevech.
- Pozdní kolaps (late model collapse): model míchá různé módy původních rozdělení a konverguje k rozdělení, které původnímu téměř neodpovídá, často s velmi malým rozptylem.
Důležité je, že podle autorů jde o proces, který nastává i bez změny rozdělení v čase a je nevyhnutelný i za téměř ideálních podmínek (bez chyby aproximace funkce), protože vzorků je konečný počet.
Proč to vzniká: konečný počet vzorků
Hlavním zdrojem je statistická aproximační chyba: při každém „přeučení“ ze vzorků existuje nenulová pravděpodobnost, že se informace ztratí. Studie to ilustruje na jednoduchém příkladu: události s pravděpodobností menší než 1/M (kde M je velikost vzorku) se v dalším vzorku v průměru neobjeví, a proto je model neuvidí a „zapomene“ je. Postupně se z rozdělení stává jediný bod. Dalšími zdroji chyb jsou omezená vyjadřovací schopnost a aproximace funkce modelem.
Obrazně: kdyby si generace studentů opisovala sešity od předchozí generace, drobné chyby a vynechávky by se hromadily, vzácná témata by vypadla a výsledek by se podobal čím dál víc „průměru“.
Experimenty
Autoři demonstrovali kolaps na:
- Gaussovských směsných modelech (GMM) a variačních autoenkodérech (VAE): po několika generacích se rozdělení „zhroutí“ k průměru; u autoenkodéru na číslicích po 20 generacích generované obrázky vypadaly jako směs různých číslic.
- Jazykovém modelu OPT-125m doladěném na datech wikitext2. Základní model dosáhl perplexity 34 (z výchozích 115), tedy se úlohu naučil. Když se další generace učily jen z dat generovaných předchozí generací, výkon se zhoršoval (v jednom nastavení o 20 až 28 bodů perplexity). Když se v každé generaci zachovalo 10 % původních dat, byla degradace výkonu jen malá. Generovaná data navíc měla delší ocasy: obsahovala posloupnosti, které by původní model nikdy nevytvořil, tedy akumulované chyby.
Autoři uvádějí, že experimenty s jazykovým modelem byly záměrně provedeny v menším, realistickém měřítku, protože trénování jednoho velkého modelu je energeticky náročné.
Co z toho plyne
- Lidská data jsou cenná. Podle studie je pro učení, kde záleží na ocasech rozdělení, nutný přístup k datům vytvořeným lidmi. Použití LLM v masovém měřítku k publikování obsahu na internetu může znečistit sběr dat pro jejich trénink.
- Vzácné jevy jsou důležité. Schopnost modelů zachytit události s nízkou pravděpodobností je podle autorů zásadní pro férovost predikcí, protože takové události často souvisejí s marginalizovanými skupinami. Jejich ztráta tedy nemusí být jen technický problém.
- „Výhoda prvního“ (first mover advantage). Subjekty, které sesbíraly data před masovým rozšířením generované AI, mohou mít výhodu.
- Původ obsahu. Aby se učení udrželo, je nutné zachovat přístup k původnímu zdroji dat a k datům nevytvořeným LLM. Studie upozorňuje, že není jasné, jak sledovat obsah generovaný LLM ve velkém měřítku; jednou možností je koordinace napříč celou komunitou, aby si strany sdílely informace o původu. Příbuzné technologie viz Značení AI obsahu – watermarking a C2PA.
Co to znamená pro běžného uživatele
Studie nepopisuje, že dnešní chatboti „blbnou“. Říká, že při bezohledném rekurzivním trénování na vlastních výstupech by mohlo docházet k degradaci. V praxi poskytovatelé používají kombinace kurátorovaných dat, filtrování a dalších technik; konkrétní postupy se liší a nejsou vždy veřejné. Pro uživatele z toho plyne několik praktických poznatků:
- Kritický přístup k obsahu. Internet je čím dál víc plný automaticky vytvářených textů; ověřujte důležité informace u primárních zdrojů; viz Dezinformace a AI propaganda.
- Různorodost zdrojů. Nespoléhejte se na jediný AI výstup; porovnávejte.
- Transparentnost. Oceňujte služby, které uvádějí zdroje a původ obsahu.
- Vlastní data. Pro firmy je cenné mít kvalitní, ověřená lidská data (dokumentace, znalosti, zpětná vazba zákazníků).
- Pozor na zkreslení. Pokud se AI učí z dat se zkreslením, může jej zesilovat; viz Rizika AI – bias a diskriminace.
Pro firmy: syntetická data
Syntetická (uměle vytvořená) data se používají legitimně, například k doplnění vzácných scénářů, ochraně soukromí či testování. Studie ale připomíná, že nahrazení skutečných dat výlučně syntetickými může způsobit ztrátu vzácných jevů. Doporučené zásady:
- Zachovejte reálná data. Experimenty ukazují, že ponechání části původních dat výrazně zmírňuje degradaci.
- Označujte původ dat (lidská, syntetická, z jakého modelu).
- Testujte na reálných datech, ne na těch, která vytvořil tentýž model.
- Sledujte vzácné případy a jejich výkon.
- Dokumentujte postup; viz NIST AI RMF a NIST AI Risk Management Framework.
Další zdroje a související pojmy
Základy toho, jak se jazykové modely učí a z čeho, najdete v úvodu Google – Introduction to LLMs. Otevřenost informací o trénovacích datech řeší definice Open Source AI Definition, která u skutečně otevřené AI požaduje popis původu a filtrování dat; více v článku Co je opravdu open-source AI. K tomu, jak AI převádí texty na vektory a hledá podobnost, viz Embeddingy a vektorové vyhledávání.
Praktický příklad (smyšlený)
Nakladatelství trénuje model na článcích a rozhodne se rozšířit sadu o texty, které předchozí verze modelu vygenerovala. Po několika kolech si redaktoři všimnou, že odpovědi jsou „hladké“, ale bez zajímavých detailů a výjimek. Tým se vrátí k původním ručně psaným textům, přidá je zpět a označí syntetické texty. Kvalita výstupů se zlepší. Příklad je smyšlený a ilustruje princip popsaný ve studii.
Podle studie Shumailova a kol. učení z dat vytvořených jinými modely vede k tomu, že mizí vzácné jevy a model se odchyluje od reality. Zachování části původních lidských dat degradaci zmírňuje.
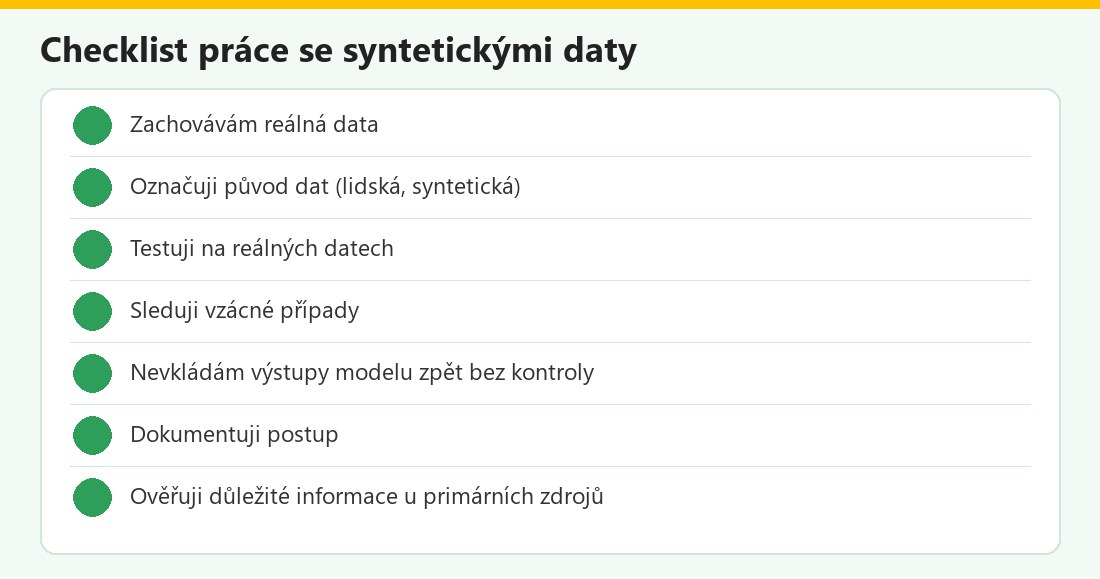 Kontrolní seznam – vlastní infografika
Model collapse v kostce
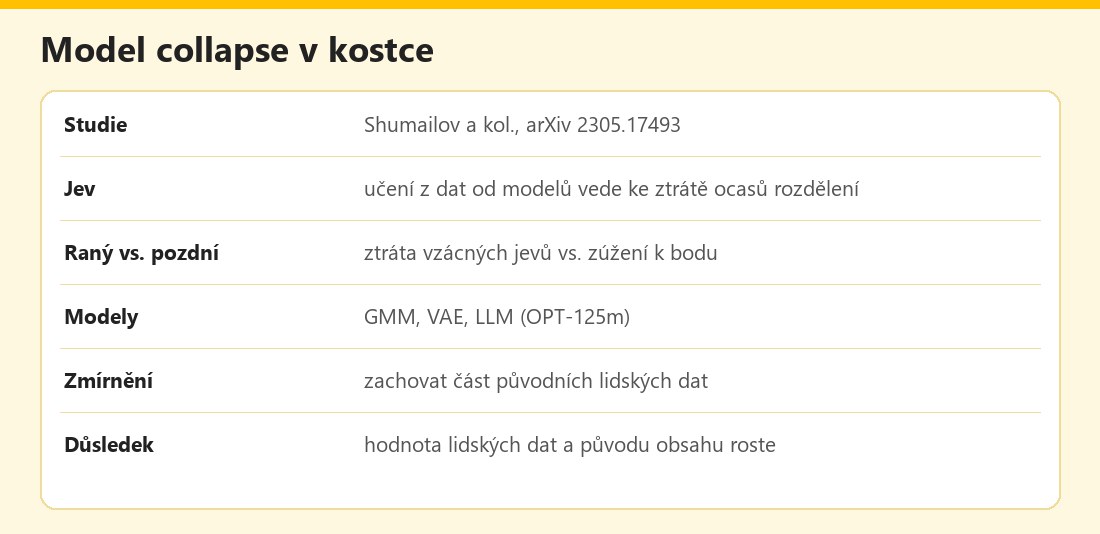 Základní údaje – vlastní infografika
Výhody a nevýhody
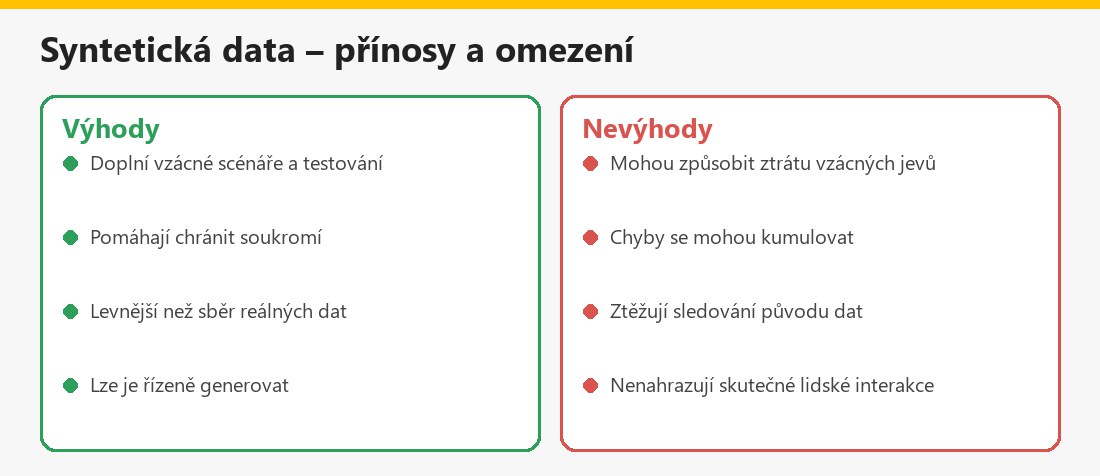 Souhrn – vlastní infografika
Související články
V kategorii Základy a principy AI najdete také Historie umělé inteligence a Generativní vs. klasická AI.
Shrnutí
Studie Shumailova a kol. ukazuje, že učení z dat vytvořených jinými modely způsobuje model collapse: mizí vzácné jevy a model se odchyluje od reality. Autoři jev doložili u GMM, VAE i jazykového modelu OPT-125m. Zachování části původních dat degradaci zmírňuje. Z toho plyne hodnota lidských dat a potřeba sledovat původ obsahu. Pro uživatele: ověřujte informace, porovnávejte zdroje. Nejde o odborné poradenství.
Často kladené otázky k model collapse
Co je model collapse?
Degenerativní proces, při němž se modely učící z dat vytvořených jinými modely odchylují od skutečného rozdělení a ztrácejí vzácné jevy.
Jaký je rozdíl mezi ranným a pozdním kolapsem?
Raný kolaps ztrácí ocasy rozdělení, pozdní míchá módy a konverguje k rozdělení s velmi malým rozptylem.
Znamená to, že dnešní chatboti blbnou?
Studie to netvrdí; popisuje riziko při rekurzivním trénování na vlastních výstupech, doloženo na menších modelech.
Pomáhá zachování původních dat?
Ano, v experimentu s OPT-125m zachování 10 % původních dat vedlo jen k malé degradaci.
Proč jsou lidská data cenná?
Pro učení, kde záleží na vzácných jevech, je podle studie nutný přístup k datům vytvořeným lidmi.
Co je první výhoda?
Subjekty se sesbíranými daty z doby před masovým rozšířením generované AI mohou mít výhodu.
Jak souvisí se sledováním původu?
Podle studie není jasné, jak sledovat obsah vytvořený LLM ve velkém; navrhuje koordinaci komunity.
Je to odborné poradenství?
Ne, jde o obecné shrnutí.
