
Otrava dat a modelů (OWASP LLM04) – manipulace trénovacích dat, zadní vrátka a obrana
Útok na AI nemusí směřovat na hotový model. Stačí otrávit data, ze kterých se učí: vložit do nich zkreslené příklady, škodlivé texty nebo skrytý „spouštěč“, který bude model později poslouchat. Takový útok se nazývá data and model poisoning (otrava dat a modelů) a OWASP jej v žebříčku rizik pro aplikace s LLM zařazuje jako LLM04:2025. Tento článek vysvětluje, jak otrava probíhá, jaké má následky a jak se bránit, a to i bez hlubokých technických znalostí.
Informace vycházejí z popisu rizika LLM04:2025 Data and Model Poisoning na webu OWASP, z přehledu OWASP Top 10 for LLM Applications a ze studie o kolapsu modelů arXiv:2305.17493 (stav k 14. 11. 2026). Nejde o technický návod ani o doporučení konkrétního produktu.
Související články: OWASP Top 10 pro LLM aplikace, Kolaps modelu – učení z dat od AI a Embeddingy a vektorové vyhledávání.
Aktualizováno: listopad 2026.
Co je otrava dat
Podle OWASP jde o manipulaci s daty pro předtrénink, doladění či embeddingy s cílem zavést zranitelnosti, zadní vrátka nebo zkreslení. Důsledky:
- zhoršený výkon modelu,
- zkreslený či toxický obsah,
- zneužití navazujících systémů.
Cílem útoku je integrita modelu: pokud jsou data upravena, model se naučí chybné vzorce a jeho předpovědi nejsou správné. Největší riziko představují externí zdroje dat, protože jejich obsah může být neověřený či škodlivý.
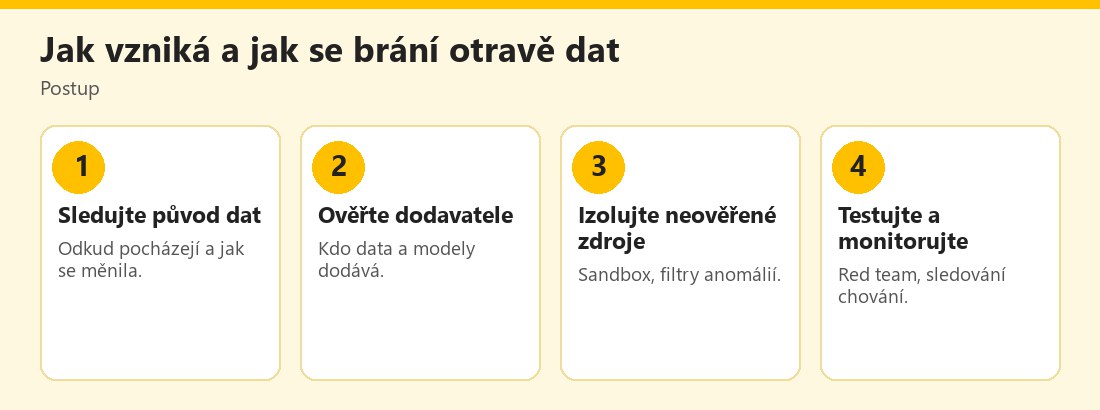 Postup obrany proti otravě dat – vlastní infografika
Zadní vrátka a „spící agenti“
OWASP upozorňuje na zvláštní nebezpečí: zadní vrátka (backdoors) mohou ponechat chování modelu beze změny, dokud je nespustí konkrétní spouštěč (trigger). Takový model projde běžnými testy, ale ve vhodnou chvíli udělá něco jiného, například obejde ověření, odešle data nebo provede skrytý příkaz. Proto se mluví o riziku „spícího agenta“: je těžké jej otestovat a odhalit.
Modely ze sdílených repozitářů
OWASP uvádí, že modely sdílené přes repozitáře či open source platformy mohou obsahovat malware, například kód, který se spustí při načtení modelu (technika zneužívající serializaci „pickle“). Stažení neověřeného modelu je proto podobné jako spuštění neznámého programu; viz Co je opravdu open-source AI.
Typické příklady
OWASP uvádí mimo jiné:
- Vkládání škodlivých trénovacích dat, která vedou ke zkresleným výstupům, například technikami typu „split-view“ či „frontrunning poisoning“.
- Přímé vložení škodlivého obsahu do tréninku, které snižuje kvalitu výstupů.
- Neúmyslné vkládání citlivých údajů uživateli při interakci, které se později mohou objevit ve výstupech.
- Neověřená trénovací data, která zvyšují pravděpodobnost zkreslených či chybných výstupů.
- Neomezený přístup k zdrojům, kdy se do systému dostanou nebezpečná data.
Scénáře útoků
- Zkreslení výstupů pomocí manipulovaných dat nebo prompt injection k šíření dezinformací.
- Neodfiltrovaná toxická data vedoucí k nebezpečným či zaujatým výstupům.
- Falešné dokumenty od konkurenta či škůdce, které model převezme jako fakta.
- Slabé filtrování umožňující vložit zavádějící data přes prompt injection.
- Zadní vrátka s triggerem, která umožní obejít ověření, vynést data nebo spustit skrytý příkaz.
Prevence a zmírnění podle OWASP
- Sledujte původ a transformace dat (například pomocí OWASP CycloneDX či ML-BOM) a ověřujte legitimitu na každé vývojové úrovni.
- Důkladně prověřte dodavatele dat a validujte výstupy proti důvěryhodným zdrojům.
- Izolujte (sandbox) modely vystavené neověřeným datům a použijte detekci anomálií.
- Doladění na datech pro konkrétní použití zlepší přesnost.
- Infrastrukturní kontroly, které modelům zabrání přístupu k nezamýšleným zdrojům.
- Verzování dat (například DVC) pro sledování změn a odhalení manipulace.
- Uživatelská data ukládejte do vektorové databáze, kde je lze upravit bez nového tréninku.
- Testujte odolnost (red team, adversarial techniky).
- Sledujte trénovací ztrátu a chování modelu; prahové hodnoty upozorní na anomálie.
- Používejte RAG a „uzemnění“ (grounding) při inferenci ke snížení rizika halucinací; viz RAG a fine-tuning.
Souvislost s dalšími riziky
- RAG a vektorové databáze. Otrávený dokument v databázi může modelu podsunout nepravdivé informace nebo skryté pokyny; viz Embeddingy a vektorové vyhledávání a Prompt injection.
- Syntetická data. Studie o kolapsu modelu ukazuje, že učení z dat vytvořených modely vede ke ztrátě vzácných jevů; to není stejný problém jako cílený útok, ale také jde o znečištění trénovací sady; viz Kolaps modelu.
- Dezinformační kampaně. Zveřejňování velkého množství zavádějícího obsahu na webu může ovlivnit modely učené z webu; viz Dezinformace a AI propaganda.
Co z toho plyne pro běžné uživatele
- Nevěřte AI nekriticky. Model může obsahovat zkreslení nebo chybné informace; ověřujte důležité údaje.
- Používejte důvěryhodné nástroje. U neznámých modelů a „AI aplikací“ je riziko vyšší; viz Falešné AI aplikace a rozšíření.
- Pozor na citlivé údaje. OWASP upozorňuje, že uživatelé mohou neúmyslně vkládat citlivé či důvěrné informace, které se pak mohou objevit ve výstupech; viz Únik dat do AI chatbotů.
- Hlaste podezřelé chování poskytovateli.
Co z toho plyne pro firmy
- Znejte původ dat a modelů, které používáte; vyžádejte dokumentaci; viz Model cards.
- Neprovozujte neověřené modely v produkčním prostředí; používejte izolaci.
- Kontrolujte obsah, který vkládáte do znalostních bází (RAG).
- Zaveďte schvalování zdrojů dat a verzování.
- Testujte chování modelu na neobvyklých vstupech a sledujte anomálie.
- Dokumentujte rizika podle rámce, například NIST AI RMF; rámec doporučuje i řízení rizik třetích stran.
Kde najít další informace
Rámec NIST AI RMF doporučuje zahrnout řízení rizik třetích stran, například dodavatelů dat a softwaru, a dokumentovat původ a kvalitu dat. Komunitní organizace OWASP nabízí ke každému riziku LLM samostatné stránky, například Improper Output Handling a System Prompt Leakage; doporučení Anthropic k agentním systémům připomíná, že tam, kde model pracuje s nástroji a externími daty, je třeba počítat s kumulací chyb a testovat v izolovaném prostředí (Building effective agents).
Jak poznat možnou otravu v provozu
Příznaky mohou zahrnovat: náhlou změnu chování modelu po aktualizaci dat; systematické zkreslení u určitých témat; neobvyklé odpovědi na konkrétní fráze (možný spouštěč); rozdíl mezi testy a reálným provozem; stížnosti uživatelů na nesmyslné či nebezpečné doporučení; neobvyklou aktivitu modelu či navazujících nástrojů. OWASP doporučuje sledovat trénovací ztrátu a chování modelu a používat prahové hodnoty pro upozornění na anomálie, a také zjišťovat původ dat; proto je důležité zachovat verze dat a modelů, aby bylo možné vrátit se k čisté verzi. Pokud máte podezření, model izolujte, vraťte předchozí verzi, prověřte zdroje dat a případně incident nahlaste podle pravidel organizace.
Etika a odpovědnost
Otrava dat není jen technický problém: může způsobit diskriminaci, šíření dezinformací či škody lidem, kteří se na výstupy spoléhají (například v hodnocení žádostí či nábor). Organizace by proto měly pravidelně přezkoumávat výstupy a zapojit lidský dohled, zejména u rozhodnutí s dopadem na lidi; viz Rizika AI – bias a diskriminace a AI v náboru a pracovních pohovorech.
Praktický příklad (smyšlený)
Firma doladí model na datech z veřejných fór, aby odpovídal zákazníkům. Po čase si všimne, že model u určité fráze doporučuje konkrétního dodavatele. Zjistí, že konkurent do fór vložil velké množství příspěvků s touto frází. Firma data očistí, zavede ověřování zdrojů a dodavatele kontroluje; model znovu doladí a zavede testy na neobvyklé spouštěče. Příklad je smyšlený.
Otrava dat manipuluje trénovací, doladěná či embedding data a může do modelu vložit zkreslení nebo zadní vrátka s tajným spouštěčem. Sledujte původ dat, ověřujte dodavatele, izolujte neověřené zdroje a testujte.
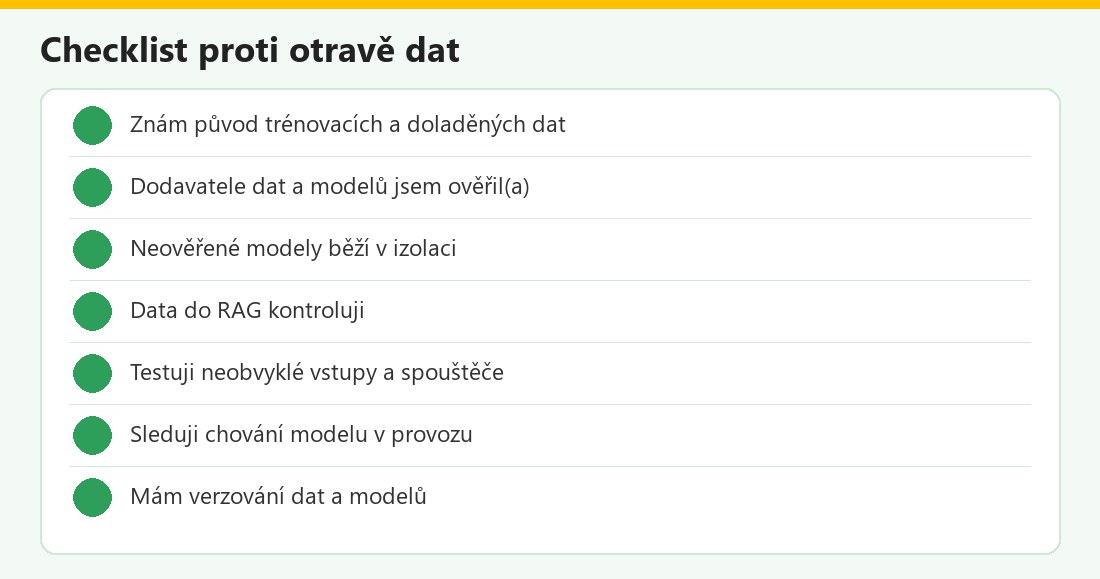 Kontrolní seznam – vlastní infografika
Otrava v kostce
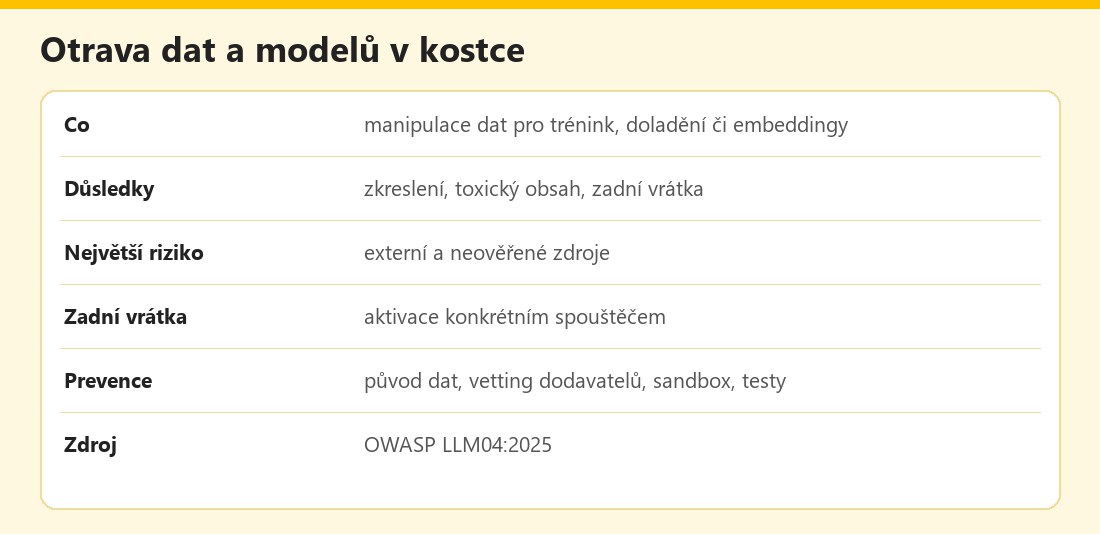 Základní údaje – vlastní infografika
Výhody a nevýhody
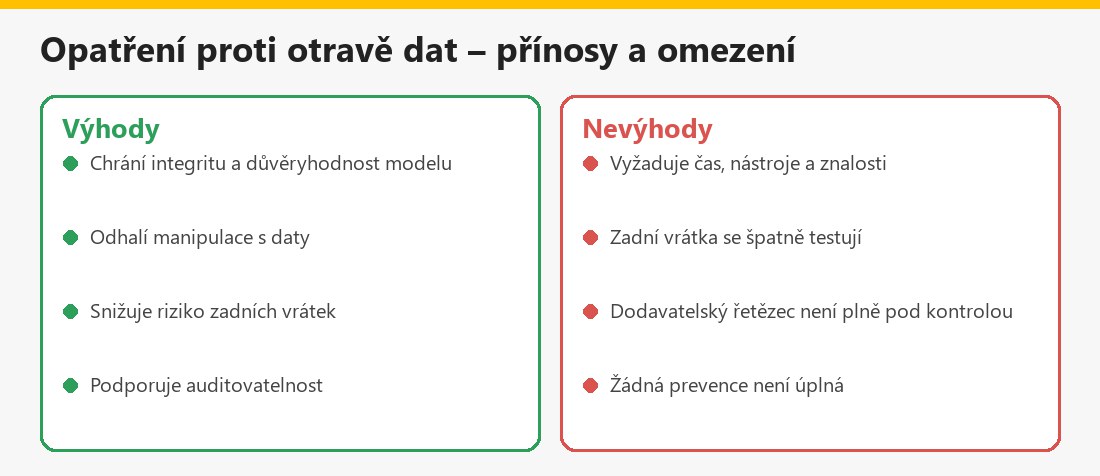 Souhrn – vlastní infografika
Související články
V kategorii Bezpečnost, etika a rizika AI najdete také Rizika AI – bias a diskriminace a Etika AI a autorská práva.
Shrnutí
Otrava dat a modelů (OWASP LLM04) je manipulace s daty pro předtrénink, doladění či embeddingy, která může způsobit zkreslení, toxický obsah či zadní vrátka aktivovaná spouštěčem. Riziková jsou zejména externí zdroje dat a modely ze sdílených repozitářů. Obrana: sledovat původ dat, ověřovat dodavatele, izolovat neověřené zdroje, testovat a monitorovat. Nejde o technický návod.
Často kladené otázky k otravě dat
Co je otrava dat?
Manipulace dat pro trénink, doladění či embeddingy, která poškodí integritu modelu.
Co jsou zadní vrátka?
Skryté chování modelu aktivované konkrétním spouštěčem, které běžné testy neodhalí.
Odkud hrozí největší riziko?
Z externích a neověřených zdrojů dat.
Mohou být nebezpečné i stažené modely?
Ano, modely ze sdílených repozitářů mohou obsahovat malware spuštěný při načtení.
Jak se bránit?
Sledovat původ dat, ověřovat dodavatele, izolovat neověřené zdroje, testovat a monitorovat.
Jak souvisí s RAG?
Otrávený dokument v databázi může modelu podsunout nepravdivé informace.
Je to totéž co model collapse?
Ne, kolaps vzniká učením z dat vytvořených modely; otrava je cílený útok.
Je to technický návod?
Ne, jde o obecné shrnutí.
