
Jailbreak AI modelů – co to je, proč funguje, rizika, obrana a proč se jej nevyplatí zkoušet
Chatboti jako ChatGPT, Gemini či Claude mají zabudovaná pravidla: odmítnou návod na výrobu zbraně, pomoc s trestným činem nebo nenávistný obsah. Jailbreak označuje pokus tato omezení obejít, tedy přimět model k chování, které by běžně odmítl. Název je převzat z „jailbreaku“ mobilních telefonů. Jde o tichý souboj mezi uživateli, kteří hledají mezery, a vývojáři, kteří je zalepují. Pro běžné uživatele je téma důležité ze tří důvodů: vysvětluje, proč bezpečnostní filtry AI nejsou neprůstřelné, ukazuje, jak mohou být zneužity firemní chatboti a upozorňuje, že pokusy o jailbreak mohou mít důsledky (zablokování účtu, porušení podmínek, rizikový obsah).
V článku se záměrně nebudeme zabývat konkrétními postupy ani funkčními „kouzelnými větami“. Vysvětlujeme, co jailbreak je a jak funguje na obecné úrovni, jak se liší od prompt injection, proč jej nelze úplně odstranit, jaká jsou rizika, jak se vývojáři a firmy brání a co z toho plyne pro uživatele. Čerpáme z přehledů FlowHunt: Jailbreaking AI chatbotů, Kaspersky: jailbreaky ChatGPT, populárně naučného článku Science News Explores: jailbreaky a „zlá“ stránka chatbotů, výzkumu Anthropic: Many-shot jailbreaking a Anthropic: Constitutional Classifiers včetně komentáře Simona Willisona, a vědecké práce o optimalizovaných útocích Universal and Transferable Adversarial Attacks on Aligned Language Models. Část údajů v preprintech a blozích nebyla nezávisle ověřena, proto čísla berte jako ilustraci.
Související články: Prompt injection, Bezpečnost a etika používání umělé inteligence a Jak se trénuje AI model.
Aktualizováno: listopad 2026.
Co je jailbreak
- Bezpečnostní omezení („zarovnání“, alignment) vznikají při dotrénování modelu (například učením podle lidské zpětné vazby) a doplňují je filtry a systémové pokyny. Cílem je, aby model odmítal škodlivé žádosti a choval se užitečně a bezpečně.
- Jailbreak je vstup (nebo série vstupů), kterým se uživatel snaží obejít tato omezení a získat zakázanou odpověď. Nejde o hacknutí serveru, ale o manipulaci s modelem pomocí textu.
- Slavný příklad: v roce 2023 se rozšířily „role-play“ zadání typu DAN („Do Anything Now“), v nichž se model měl vžít do postavy bez pravidel. Po jejich blokování se objevovaly nové varianty; Kaspersky a další popisují tento „souboj záplat a obcházení“.
- Cíl útočníků bývá různý: získat návod k nebezpečné činnosti, vytvořit nenávistný či klamavý obsah, obejít cenzuru, vyzkoušet limity, nebo pouze ze zvědavosti.
- Rozdíl od jiných pojmů: prompt injection cílí na aplikaci a její data či nástroje (viz Prompt injection); jailbreak cílí na bezpečnostní chování modelu. V praxi se techniky mohou překrývat.
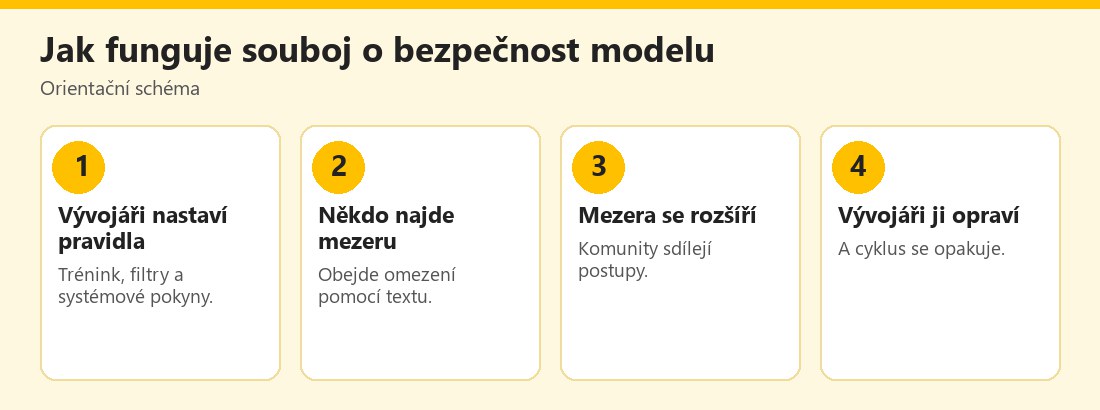 Orientační schéma souboje jailbreak a obrana – vlastní infografika
Jak jailbreak funguje (obecně)
Jazykový model je statistický systém: odmítavé chování je naučená tendence, nikoli pevné pravidlo. Proto lze jeho chování ovlivnit samotným kontextem. Výzkum a bezpečnostní přehledy popisují kategorie útoků, aniž je nutné je návodně rozepisovat:
- Hraní rolí a fikce: žádost se zabalí do příběhu, hry či „hypotetické“ situace, takže model ztratí zřetel na skutečný záměr.
- Dlouhý kontext: podle výzkumu Anthropic tzv. many-shot jailbreaking využívá velkých kontextových oken; do jediného promptu se vloží velké množství vymyšlených dialogů, v nichž asistent vyhoví škodlivým žádostem, a model se tímto vzorem nechá ovlivnit. Anthropic uvádí, že útok fungoval i na modelech jiných firem a že souvisí s rostoucí délkou kontextu (viz Tokeny a kontextové okno).
- Obfuskace a kódování: skrytí významu překlepy, jazykovými změnami či kódováním, aby filtr zpráv nepoznal záměr.
- Optimalizované útoky: vědecká práce Universal and Transferable Adversarial Attacks ukázala, že lze automaticky hledat posloupnosti znaků, které model přimějí vyhovět, a že takové útoky se mohou přenášet mezi modely.
- Postupné vyjednávání: dlouhý rozhovor, v němž se omezení po malých krocích rozvolňují.
- Zneužití nástrojů a vícejazyčnosti: omezení v méně běžných jazycích bývají slabší.
Všechny tyto techniky využívají toho, že model nechápe záměr jako člověk. Různé zdroje uvádějí různé úspěšnosti; ty zpravidla pocházejí z testů na konkrétních verzích modelů, které byly mezitím aktualizovány.
Poskytovatelé v podmínkách služby obvykle zakazují obcházení bezpečnostních opatření a mohou omezit či zablokovat účet. Získaný „zakázaný“ obsah může být navíc nepřesný a nebezpečný: model si i bez pravidel může vymýšlet.
Rizika
- Škodlivý obsah: návody k nebezpečným činnostem, nenávistné či manipulativní texty; i když je model „zlomen“, kvalita informací může být špatná. Viz Proč AI halucinuje.
- Podvody a zneužití: jailbreaknuté nebo „bez cenzury“ nástroje se nabízejí na internetu pro tvorbu phishingu a malwaru; viz Podvody s AI: phishing a vishing a AI v kybernetických útocích.
- Firemní chatboti: zákaznický bot lze přimět prozradit interní pokyny, nabídnout neoprávněné slevy či vytvořit reputační škodu; viz AI pro zákaznický servis ve firmě.
- Děti a mládež: sdílení „návodů na obejití“ mezi vrstevníky a riziko nevhodného obsahu; viz AI chatboti a děti.
- Falešné „jailbreak“ služby: weby a aplikace slibující „ChatGPT bez omezení“ mohou obsahovat malware či sbírat údaje; viz Falešné AI aplikace a rozšíření.
- Právní odpovědnost: za použití získaného obsahu odpovídá uživatel; viz Kdo nese odpovědnost za chyby AI.
- Psychologický efekt: „uvolněný“ model může znít sebejistě a přesvědčivě, i když je jeho odpověď škodlivá či nepravdivá.
Proč jej nelze úplně odstranit
Bezpečnostní chování modelu je naučená tendence, a proto lze vždy najít vstup, který ji překoná. Útočníci i výzkumníci stále nalézají nové postupy; opravy jednotlivých zadání nestačí, protože se objeví další varianty. Podobné závěry vyplývají z přehledů FlowHunt a Kaspersky. Důsledek: je třeba počítat s vrstvenou obranou a s tím, že žádný model není absolutně odolný.
Jak se vývojáři brání
- Lepší trénink a dotrénování na odmítání: účinné, ale podle Anthropic u many-shot útoku problém jen oddálilo.
- Omezení délky kontextu: výzkum je zmiňuje, ale je to nežádoucí z hlediska užitečnosti.
- Klasifikátory vstupu a výstupu: samostatné modely kontrolují, zda zadání či odpověď nejsou škodlivé. Anthropic popisuje, že u many-shot útoku klasifikace a úprava promptu snížila jeho úspěšnost z 61 % na 2 %. Další práce Constitutional Classifiers uvádí, že v automatických testech klesla úspěšnost jailbreaků z 86 % na 4,4 % a že ve veřejné soutěži nikdo nedokázal jediným postupem přimět model ke všem deseti zakázaným odpovědím; Anthropic výslovně uvádí, že metoda nemusí zabránit každému univerzálnímu jailbreaku. Jde o údaje výrobce, nezávisle je nelze ověřit; viz též komentář Simona Willisona.
- Red teaming: tým záměrně útočí na model před vydáním, aby slabiny našel dřív než zneuživatelé; viz Bezpečnost a etika používání umělé inteligence.
- Programy odměn (bug bounty) za nalezení jailbreaků.
- Monitorování a omezování zneužití: detekce opakovaných pokusů, blokace účtů.
- Aktualizace modelů a rychlá reakce na nově objevené techniky.
- Transparentnost a standardy: rámce jako OWASP pro aplikace s LLM (genai.owasp.org) pomáhají firmám systematicky řešit rizika.
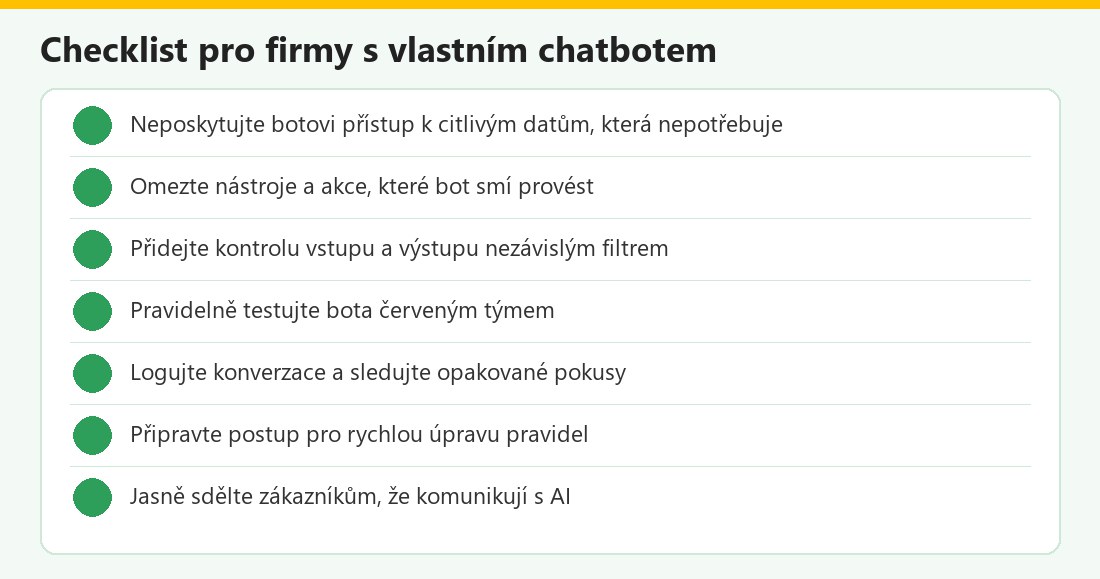 Kontrolní seznam – vlastní infografika
Co z toho plyne pro uživatele
- Nezkoušejte jailbreak na veřejných službách: porušujete podmínky, riskujete zablokování a získaný obsah bývá nespolehlivý.
- Nedůvěřujte „bezcenzurním“ AI službám: často jde o podvod, sběr dat či malware.
- Chápejte omezení filtrů: že AI něco odmítla, neznamená, že je to nebezpečné; že odpověděla, neznamená, že je to správné či bezpečné.
- Rodiče: promluvte s dětmi o tom, proč mají chatboti omezení a proč je „obcházení“ riskantní; viz AI chatboti a děti.
- Studenti a výzkumníci: legitimní zkoumání bezpečnosti AI probíhá v rámci pravidel a programů odpovědného zveřejňování.
- Firmy: počítejte s tím, že každý veřejný chatbot bude testován; nastavte omezená oprávnění a monitoring; viz Firemní politika používání AI.
- Obecně: používejte AI s ohledem na Bezpečné používání AI: checklist.
Jailbreak v kostce
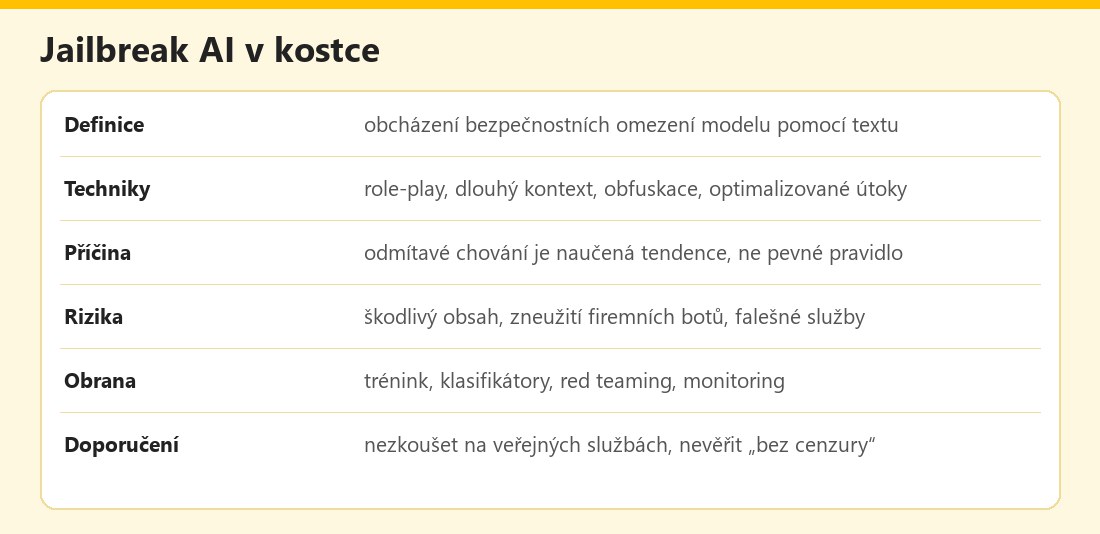 Základní údaje – vlastní infografika
Výhody a nevýhody
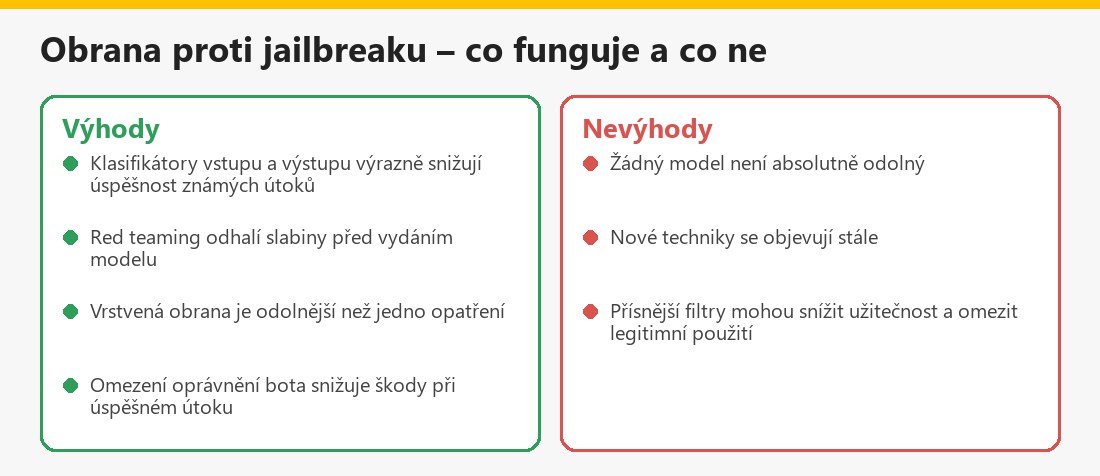 Souhrn pro uživatele – vlastní infografika
Související články
V kategorii Bezpečnost, etika a rizika AI najdete také Rizika AI: bias a diskriminace, Deepfake: jak poznat a Únik dat do AI chatbotů.
Shrnutí
Jailbreak je obcházení bezpečnostních omezení AI pomocí textu; funguje, protože odmítavé chování modelu je naučená tendence. Techniky jako hraní rolí, dlouhé kontexty či optimalizované útoky se stále objevují a úplné odstranění není pravděpodobné. Vývojáři používají trénink, klasifikátory, red teaming a monitoring. Uživatelům se jailbreak nevyplatí: porušují podmínky, získaný obsah bývá nespolehlivý a „bezcenzurní“ služby jsou často podvod.
Často kladené otázky k jailbreaku AI
Co je jailbreak AI modelu?
Pokus obejít bezpečnostní omezení chatbotu pomocí speciálně formulovaného textu, aby odpověděl na to, co by jinak odmítl.
Čím se liší od prompt injection?
Jailbreak cílí na bezpečnostní chování modelu, prompt injection na aplikaci, její data a nástroje; techniky se mohou překrývat.
Proč funguje?
Odmítavé chování je naučená statistická tendence, kterou lze změnit kontextem, nikoli pevné pravidlo.
Dá se jailbreak úplně odstranit?
Nejspíš ne; vývojáři jej snižují vrstvenou obranou, ale nové techniky se objevují.
Je jailbreak nezákonný?
Obvykle porušuje podmínky služby; protiprávní může být využití získaného obsahu. Odpovědnost nese uživatel.
Jak se brání vývojáři?
Tréninkem na odmítání, klasifikátory vstupu a výstupu, red teamingem, monitoringem a rychlými aktualizacemi.
Jsou „AI bez cenzury“ bezpečné?
Často ne; mohou být podvodné, sbírat údaje či obsahovat malware, a obsah může být nepřesný.
Co mám dělat jako uživatel?
Nezkoušet jailbreak na veřejných službách, ověřovat informace a používat ověřené nástroje.
