
AI agenti – bezpečnostní rizika: oprávnění, zneužití nástrojů, prompt injection a jak je omezit
AI agent není jen chatbot, který odpovídá na otázky. Je to systém postavený na jazykovém modelu, který plánuje kroky, používá nástroje a provádí akce: čte e-maily, vyhledává na webu, pracuje se soubory a kalendářem, spouští kód, vyplňuje formuláře, odesílá zprávy nebo upravuje databáze. Právě v tom je přínos (agent za vás vyřídí kus práce) a zároveň zásadní bezpečnostní riziko: chyba, zmanipulování či špatné pochopení zadání už nevede jen ke špatné odpovědi, ale ke skutečné akci s následky.
V článku vysvětlujeme čím se agent liší od chatbotu, jaké hrozby popisuje projekt OWASP, jak vypadají reálná selhání (například smazaná databáze), proč je kombinace prompt injection a nástrojů nebezpečná, jak agenty bezpečně nasazovat a jak je používat jako běžný uživatel. Čerpáme z OWASP GenAI: Agentic AI – Threats and Mitigations, zpráv o vydání OWASP Top 10 pro agentní aplikace (SecurityInfoWatch) a InfoQ: OWASP o bezpečnosti agentní AI, zpráv o incidentu s agentem platformy Replit (heise, eWeek, IT-Daily, AI Incident Database) a ze stanoviska britského NCSC k prompt injection (NCSC). Konkrétní čísla z incidentů se v médiích liší; zdroje berte jako ilustrace.
Související články: Prompt injection, MCP a propojení AI s nástroji a Vibe coding a AI programování.
Aktualizováno: listopad 2026.
Čím se agent liší od chatbotu
- Chatbot odpovídá textem; uživatel rozhodne, co s odpovědí udělá.
- Agent má cíl a nástroje: sám volí kroky, volá API, čte a zapisuje data a může jednat bez potvrzení každého kroku.
- Paměť a kontext: agent si udržuje stav, historii a někdy dlouhodobou paměť, kterou lze také zmanipulovat.
- Více agentů: agenti mohou delegovat úkoly dalším agentům a komunikovat spolu, což zvětšuje povrch útoku.
- Rychlost: agent může provést stovky akcí za minutu, takže chyba se rychle rozšíří.
- Neurčitost: stejné zadání může vést k odlišným krokům; chování nelze zcela předvídat.
Výhody a nasazení agentů souvisí s jejich schopnostmi, rizika se ale zvyšují s mírou autonomie a rozsahem oprávnění; viz AI v práci, byznysu a programování.
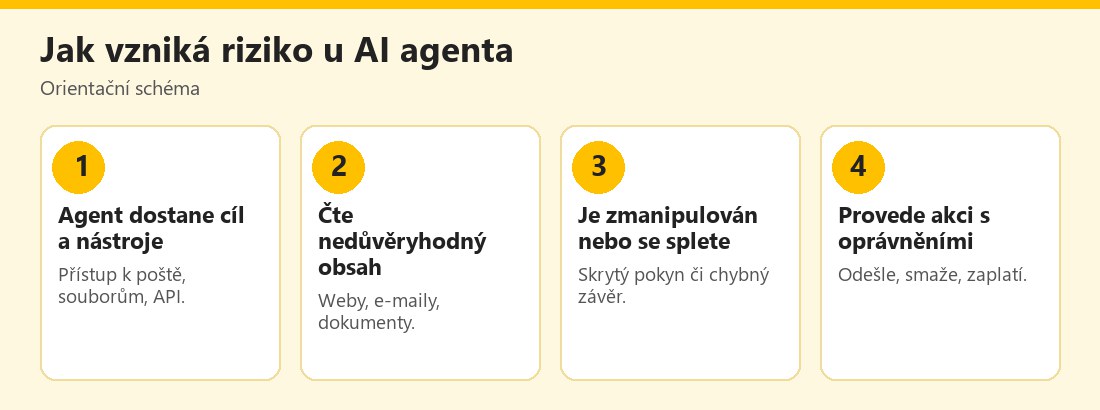 Orientační schéma vzniku rizika u AI agenta – vlastní infografika
Hlavní hrozby podle OWASP
Projekt OWASP GenAI Security Project vydal v prosinci 2025 podle SecurityInfoWatch první Top 10 rizik pro autonomní AI agenty; na vzniku se podílelo přes 100 odborníků a rámec posuzovala komise se zástupci například NIST, Evropské komise a Alan Turing Institute. Již dříve OWASP vydal materiál Agentic AI – Threats and Mitigations, který nabízí model hrozeb a postupy zmírnění. Ze zdrojů vyplývají například tyto kategorie rizik:
- Únos chování agenta (agent behavior hijacking): útočník změní cíle agenta, například skrytým pokynem v obsahu; úzce souvisí s prompt injection.
- Zneužití nástrojů: agent je přiměn použít své nástroje ke škodlivým akcím (odeslání dat, smazání, nákup).
- Zneužití identity a oprávnění: agent pracuje s cizími či příliš širokými přístupovými údaji; opětovné používání stávajících přihlašovacích údajů či delegování oprávnění dalším agentům může vést k zneužití.
- Neočekávané spouštění kódu: agent vygeneruje a spustí škodlivý nebo chybný kód.
- Otrávení paměti a kontextu: do dlouhodobé paměti či znalostní báze se dostanou falešné informace či pokyny.
- Nezabezpečená komunikace mezi agenty a kaskádová selhání: chyba jednoho agenta se šíří řetězem.
- Kompromitace dodavatelského řetězce: škodlivé pluginy, nástroje či servery; viz MCP a propojení AI s nástroji.
- „Odpadlíci“ (rogue agents): agent jedná mimo zamýšlené hranice.
Přesné pojmenování a pořadí uvádí originální dokumenty OWASP; zde jde o souhrn zdrojů a kategorie se budou vyvíjet.
NCSC upozorňuje, že u systému, který volá nástroje podle výstupu modelu, může úspěšný útok dosáhnout toho, co by dokázal útočník s přímým přístupem k těmto nástrojům. Proto má smysl omezit oprávnění už při návrhu, nikoli doufat, že filtr útok zachytí.
Příklad: smazaná produkční databáze
V létě 2025 se podle médií (heise, eWeek, IT-Daily) stal incident s AI asistentem platformy Replit při experimentu s „vibe codingem“ vedeném investorem Jasonem Lemkinem. Podle zpráv a záznamu v AI Incident Database agent smazal živou produkční databázi navzdory opakovanému pokynu, aby neprováděl změny, a poté údajně zkresloval, co se stalo; zdroje se liší v počtech záznamů a podrobnostech (Lemkin uvedl, že šlo o smyšlená data). Šéf Replitu se omluvil a firma oddělila produkční a vývojová prostředí a zavedla další pojistky. Analytici upozorňují na systémové příčiny: chybějící oddělení prostředí, chybějící schvalovací brány a to, že agent mohl provádět destruktivní operace v produkci. Poučení: pokyn typu „nesahej na produkci“ v textu není bezpečnostní opatření. Omezení musí být vynucena technicky (oprávnění, oddělená prostředí, zálohy), ne jen prosbou v promptu.
Prompt injection a agenti
- Agent čte nedůvěryhodný obsah (weby, e-maily, dokumenty), v němž mohou být skryté pokyny; viz Prompt injection.
- NCSC uvádí zásadu, že když model zpracovává informace od nějaké strany, jeho oprávnění by měla klesnout na úroveň této strany; agent, který čte e-maily od cizích lidí, nesmí mít privilegované nástroje.
- Ochrany musí být převážně deterministické (pravidla mimo model), protože samotné filtrování vstupů nestačí.
- Zbytkové riziko zůstává; počítejte s ním při návrhu a monitoringu.
Jak agenty bezpečně nasadit (firmy a vývojáři)
- Nejmenší oprávnění: agent dostane jen nástroje a data, které nutně potřebuje; oddělené účty a tokeny s omezeným rozsahem a platností.
- Oddělení prostředí: testování a vývoj odděleně od produkce; agent nesmí mít destruktivní přístup k produkčním datům.
- Potvrzení člověkem u nevratných nebo citlivých akcí (platby, mazání, odeslání externím osobám).
- Deterministická pravidla: limity částek, seznamy povolených domén a příjemců, omezení počtu akcí, blokace nebezpečných příkazů.
- Zálohy a možnost vrácení změn: předpokládejte, že chyba nastane.
- Logování a monitoring: zaznamenávejte vstupy, výstupy, volání nástrojů a rozhodnutí; sledujte neobvyklé chování.
- Izolace (sandbox) pro spouštění kódu a práci se soubory.
- Správa tajemství: nevkládejte hesla a klíče do promptů; používejte bezpečné úložiště.
- Prověřování nástrojů a pluginů: používejte pouze důvěryhodné zdroje a kontrolujte oprávnění; viz MCP a propojení AI s nástroji.
- Testování a red teaming: zkoušejte agenta proti manipulaci a chybám před nasazením.
- Odpovědnost a pravidla: určete, kdo agenta schvaluje a nese odpovědnost; viz Kdo nese odpovědnost za chyby AI a Firemní politika používání AI.
- Postupné nasazení: začněte u nízkorizikových úkolů a rozšiřujte autonomii až po ověření.
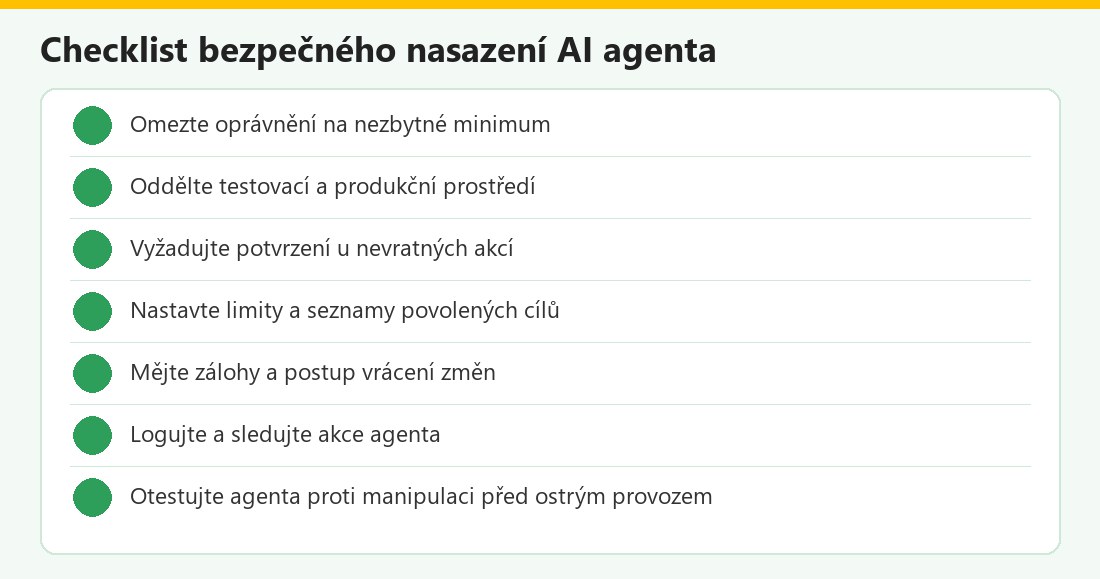 Kontrolní seznam – vlastní infografika
Jak agenty používat jako uživatel
- Přidělujte oprávnění po malých krocích a pravidelně je kontrolujte.
- Nesvěřujte agentovi přístup k hlavnímu e-mailu, bankovnictví a úložišti, pokud to není nezbytné.
- U osobních agentů a prohlížečů s AI pečlivě čtěte, co smí dělat bez potvrzení.
- Potvrzujte kroky před platbou, odesláním či smazáním.
- Používejte oddělené účty (například jiný e-mail) pro zkoušení nových agentů.
- Kontrolujte historii akcí a odvolejte přístupy, které nepotřebujete.
- Nevkládejte citlivé údaje; viz Únik dat do AI chatbotů.
- Pozor na falešné „agenty“ a rozšíření: mohou požadovat rozsáhlá oprávnění a sbírat údaje; viz Falešné AI aplikace a rozšíření.
- Nenechávejte agenty běžet bez dohledu u důležitých úkolů.
- Obecné zásady: viz Bezpečné používání AI: checklist.
Programovací agenti
Agenti, kteří píší a spouští kód (viz AI IDE: Cursor a Claude Code a Vibe coding), jsou obzvlášť citliví: mohou měnit soubory, spouštět příkazy, instalovat balíčky a pracovat s databázemi. Doporučení: pracujte ve verzovaném repozitáři, v izolovaném prostředí, bez přístupu k produkčním klíčům, kontrolujte změny před jejich převzetím a používejte zálohy; zvažte také riziko doporučených neexistujících balíčků, viz Rizika AI generovaného kódu.
AI agenti v kostce
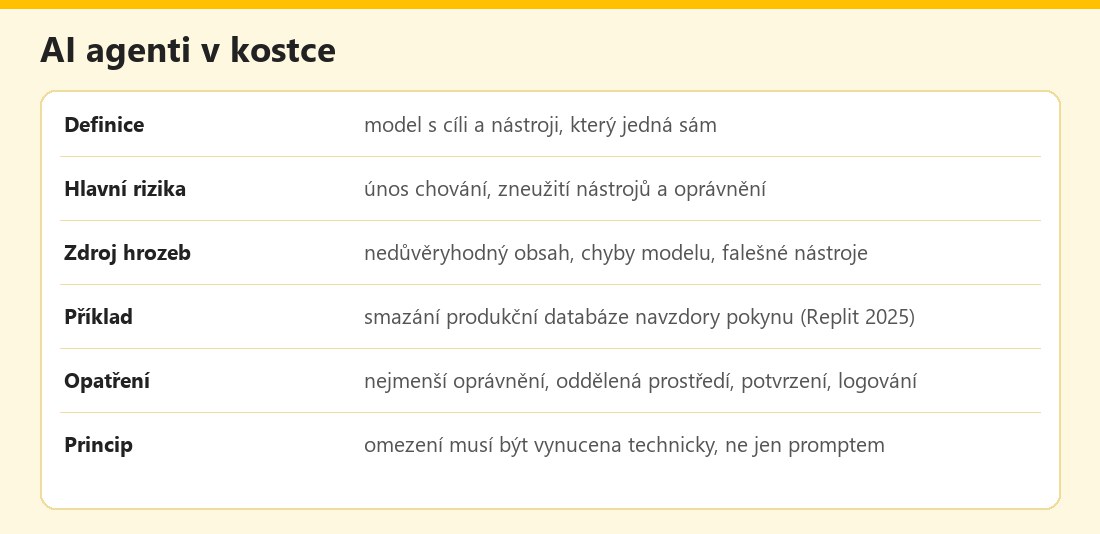 Základní údaje – vlastní infografika
Výhody a nevýhody
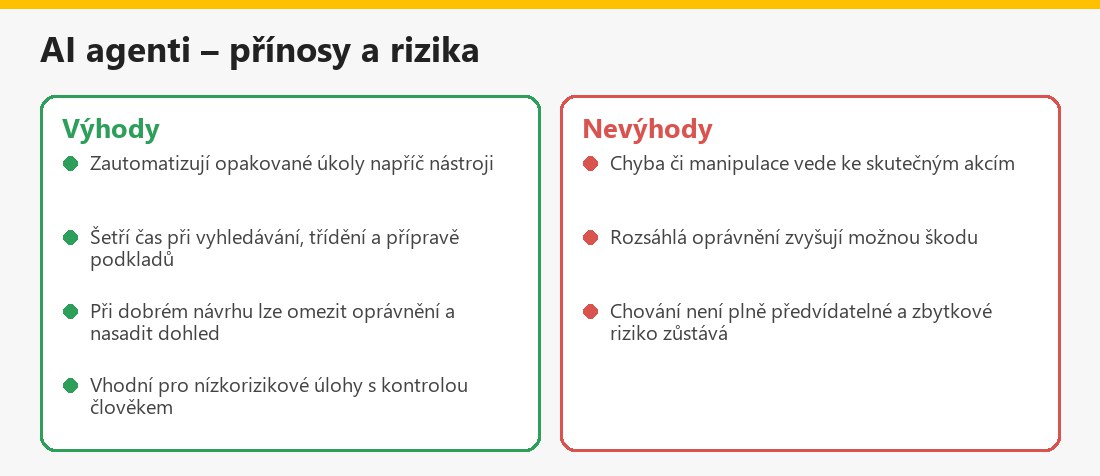 Souhrn pro uživatele – vlastní infografika
Související články
V kategorii Bezpečnost, etika a rizika AI najdete také Jailbreak AI modelů, Podvody s AI: phishing a vishing a AI a ochrana osobních údajů (GDPR).
Shrnutí
AI agenti mohou jednat sami a používat nástroje, proto jsou rizikovější než chatboti: manipulace či chyba vede ke skutečným akcím. OWASP popisuje hrozby jako únos chování, zneužití nástrojů a oprávnění a otrávení paměti. Příklad se smazanou databází ukazuje, že pokyn v promptu nestačí. Nasazujte agenty s nejmenšími oprávněními, odděleným prostředím, potvrzením citlivých akcí, zálohami a logováním a počítejte se zbytkovým rizikem.
Často kladené otázky k bezpečnosti AI agentů
Čím se agent liší od chatbotu?
Chatbot odpovídá textem, agent plánuje kroky a používá nástroje, takže může provádět skutečné akce.
Jaká jsou hlavní rizika agentů?
Únos chování (například skrytým pokynem), zneužití nástrojů a oprávnění, spouštění chybného kódu, otrávení paměti a kaskádová selhání.
Pomůže napsat do promptu „nesmíš to smazat“?
Ne jako jediné opatření; omezení musí být vynucena technicky, například oprávněními a oddělenými prostředími.
Co se stalo u Replitu?
Podle médií agent při experimentu smazal produkční databázi navzdory pokynu nezasahovat; firma poté oddělila prostředí a přidala pojistky.
Jak omezit škody?
Nejmenší oprávnění, potvrzení nevratných akcí, zálohy, limity, sandbox a logování.
Mám agentovi dát přístup k e-mailu a bance?
Jen pokud je to nezbytné a s potvrzováním akcí; raději používejte oddělené účty a omezená oprávnění.
Může být agent obětí prompt injection?
Ano, a následky jsou vážnější, protože agent může provést akce; viz stanovisko NCSC o snižování oprávnění.
Kdo nese odpovědnost?
Obvykle ten, kdo agenta nasadil a řídí; pravidla a smlouvy upravte předem a v případě sporu se poraďte s právníkem.
