
Slovník pojmů umělé inteligence – 60 nejdůležitějších výrazů od A do Z srozumitelně česky
Svět umělé inteligence přináší nové pojmy rychleji, než je stačíme vstřebávat: LLM, prompt, token, halucinace, RAG, agent, embedding, inference, jailbreak, deepfake… V článcích a médiích se často používají bez vysvětlení, někdy i nepřesně. Tento slovník shrnuje nejdůležitější výrazy srozumitelně a česky, abyste se v textech o AI neztráceli, dokázali kriticky číst tvrzení firem a vybírat nástroje, a abyste věděli, kde hledat podrobnější vysvětlení. Výrazy jsou řazeny abecedně; u mnoha najdete odkaz na samostatný článek.
V tomto slovníku najdete více než šedesát pojmů: základní (AI, strojové učení, model), technické (token, embedding, parametry, inference), praktické (prompt, kontextové okno, plugin, agent), bezpečnostní (halucinace, jailbreak, prompt injection, deepfake) a regulační (AI Act, vysoce rizikové systémy). Čerpáme z oficiálních glosářů a přehledů, například Google: Machine Learning Glossary, NIST: AI Risk Management Framework – Glossary, IBM: Artificial intelligence, Wikipedie: Umělá inteligence a Nařízení EU o umělé inteligenci (AI Act). Terminologie se vyvíjí a různí autoři ji používají mírně odlišně; uvádíme nejběžnější význam.
Další články najdete v kategorii Základy a principy AI, například Co to je umělá inteligence (AI), Strojové učení a hluboké učení a Tokeny a kontextové okno.
Aktualizováno: listopad 2026.
A–D
- Agent (AI agent): systém, který s pomocí jazykového modelu plánuje kroky a používá nástroje (prohlížeč, kód, e-mail) k dosažení cíle; viz AI agenti.
- AGI (umělá obecná inteligence): hypotetická AI se schopnostmi člověka napříč širokým spektrem úloh; viz AGI a superinteligence.
- AI Act (nařízení EU o AI): evropský zákon, který reguluje AI podle rizika použití; viz EU AI Act.
- Algoritmus: postup krok za krokem, kterým počítač řeší úlohu.
- Alignment (sladění): úsilí, aby systémy dělaly to, co lidé skutečně chtějí, a byly bezpečné.
- API: rozhraní, přes které programy komunikují s AI službou; platí se obvykle za tokeny.
- Benchmark: standardizovaný test pro srovnání modelů; viz Jak hodnotit AI modely.
- Bias (zkreslení): systematická chyba či nespravedlnost vyplývající z dat či návrhu; viz Rizika AI: bias a diskriminace.
- Chatbot: program, který komunikuje v přirozeném jazyce; moderní chatboti používají velké jazykové modely; viz Co je to ChatGPT.
- Červený tým (red team): skupina, která se záměrně pokouší model prolomit či zneužít, aby odhalila slabiny.
- Datový posun (data drift): změna reality, kvůli které model trénovaný na starších datech přestane fungovat dobře.
- Deepfake: syntetické video, zvuk či obraz, které věrohodně napodobuje skutečné osoby; viz Deepfake: jak poznat.
- Difuzní model: typ generativního modelu (obrázky, video), který vytváří obsah postupným odšuměním; viz Generativní AI vs. klasická AI.
E–L
- Embedding: číselný vektor, který zachycuje význam textu či obrázku; podobné významy mají podobné vektory; základ vyhledávání v RAG.
- Etika AI: oblast zabývající se spravedlností, odpovědností, transparentností a dopady AI.
- Fine-tuning (dolaďování): dotrénování hotového modelu na vlastních příkladech; viz RAG a fine-tuning.
- Foundation model (základní model): velký univerzální model trénovaný na rozsáhlých datech, který lze přizpůsobit mnoha úlohám.
- Generativní AI: AI vytvářející nový obsah (text, obrázky, hudbu, kód); viz Generativní AI vs. klasická AI.
- GPU: grafický procesor; díky paralelním výpočtům je základním hardwarem pro trénink a provoz modelů.
- GPT: rodina jazykových modelů (Generative Pre-trained Transformer); zkratka označuje typ architektury a tréninku.
- Halucinace: věrohodně znějící, ale nepravdivá či vymyšlená odpověď modelu; viz Proč AI halucinuje.
- Hluboké učení (deep learning): strojové učení s vícevrstvými neuronovými sítěmi; viz Strojové a hluboké učení.
- Inference: použití natrénovaného modelu k odpovědi (na rozdíl od tréninku).
- Instrukční ladění: dotrénování modelu na zadáních a vzorových odpovědích, aby následoval pokyny; viz Jak se trénuje AI model.
- Jailbreak: pokus obejít bezpečnostní omezení modelu zadáním; viz Jailbreak AI modelů.
- Kontextové okno: maximální počet tokenů, které model zpracuje najednou; viz Tokeny a kontextové okno.
- Kontaminace dat: únik testových otázek do trénovacích dat, který zkresluje výsledky benchmarků.
- LLM (velký jazykový model): neuronová síť natrénovaná na rozsáhlých textech, která umí generovat a zpracovávat jazyk.
- LoRA: úsporná metoda dolaďování pomocí malých přídavných matic.
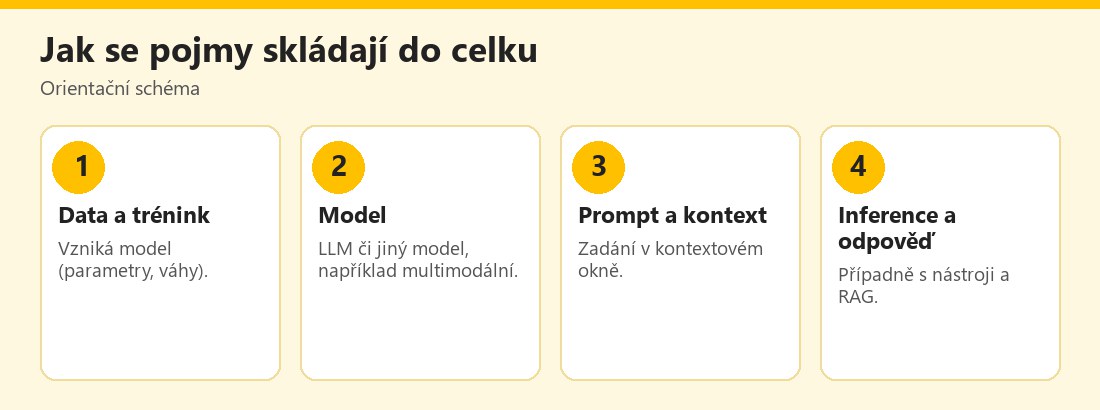 Orientační schéma vztahu klíčových pojmů AI – vlastní infografika
M–R
- Machine learning (strojové učení): část AI, v níž se model učí vzorce z dat.
- MCP (Model Context Protocol): otevřený protokol pro propojení AI aplikací s nástroji a daty; viz MCP a propojení AI s nástroji.
- Model: matematická funkce s naučenými parametry, která z vstupu vytváří výstup.
- Multimodální: model, který zpracovává více druhů dat (text, obraz, zvuk, video); viz Multimodální AI.
- Neuronová síť: model z vrstev propojených jednotek s nastavitelnými váhami, volně inspirovaný mozkem.
- NLP (zpracování přirozeného jazyka): obor zabývající se porozuměním a tvorbou lidského jazyka počítači.
- Open-source model (otevřený model): model, jehož váhy (a někdy kód) jsou dostupné ke stažení a úpravám podle licence; viz Open-source AI modely.
- Overfitting (přeučení): model se naučí tréninková data příliš přesně a selhává na nových.
- Parametry (váhy): čísla uvnitř modelu, která se upravují při tréninku; velké modely jich mají miliardy.
- Plugin / nástroj: rozšíření, které modelu umožní volat externí funkce (vyhledávání, kalkulačka).
- Pozornost (attention): mechanismus, jímž transformer váží, které části vstupu jsou pro další výstup důležité.
- Předtrénování: první fáze tréninku na obrovském korpusu, kdy se model učí předpovídat další token.
- Prompt: zadání, které modelu dáváte; viz Jak psát prompty pro AI.
- Prompt engineering: umění formulovat zadání, aby model podával lepší výsledky.
- Prompt injection: útok, při němž škodlivý text v datech modelu podstrčí vlastní pokyny; viz Prompt injection.
- RAG: vyhledávání v dokumentech kombinované s generováním odpovědi; viz RAG a fine-tuning.
- Reasoning model (model s uvažováním): model, který před odpovědí generuje dlouhý vnitřní postup úvahy; zlepšuje výsledky u složitých úloh, ale zpomaluje a zdražuje odpověď.
- RLHF: učení posilováním z lidské zpětné vazby, kterým se model dolaďuje podle preferencí lidí.
S–Z
- Samoučení (self-supervised learning): model si „štítky“ vytváří z dat sám, například předpovídá další slovo.
- Syntetická data: data vytvořená uměle (často jinou AI) pro trénink či testování.
- Systémový prompt: skryté úvodní pokyny, které poskytovatel či aplikace dává modelu (role, pravidla).
- Teplota (temperature): nastavení náhodnosti generování; nižší = předvídatelnější, vyšší = kreativnější.
- Token: kousek textu, se kterým model počítá; viz Tokeny a kontextové okno.
- Transformer: architektura neuronové sítě s mechanismem pozornosti, základ většiny jazykových modelů; vznikla 2017 (viz Historie umělé inteligence).
- Trénovací data: data, z nichž se model učí; určují jeho znalosti i zkreslení.
- Turingův test: koncept testu, zda stroj dokáže v konverzaci obstát jako člověk.
- Učení bez učitele / s učitelem / posilované: tři hlavní typy strojového učení.
- Umělá inteligence (AI): široký obor zabývající se systémy provádějícími úlohy vyžadující inteligenci; viz Co to je umělá inteligence (AI).
- Úzká AI: AI pro konkrétní úlohu, na rozdíl od hypotetické obecné AI.
- Vektorová databáze: úložiště optimalizované pro hledání podle podobnosti vektorů (embeddingů).
- Vícekrokové uvažování (chain of thought): postup, kdy model řeší úlohu po krocích; často zvyšuje přesnost.
- Watermarking (vodoznak): označení AI obsahu pro pozdější rozpoznání; viz AI značení obsahu a C2PA.
- Zero-shot / few-shot: zadání úlohy bez příkladů či s několika příklady přímo v promptu.
- Zkreslení (bias): viz výše.
Obor AI je mladý a terminologie se mění; stejné slovo může mít u různých autorů či firem mírně odlišný význam (například „agent“ nebo „AGI“). Při čtení tvrzení se vždy ptejte, jak autor pojem definuje.
Pojmy z regulace a bezpečnosti
- Vysoce riziková AI: kategorie systémů podle AI Act (například nábor, úvěrové hodnocení, zdravotnictví), které mají přísnější povinnosti.
- Zakázané praktiky: použití AI, která AI Act zakazuje (například určité formy manipulace či sociálního hodnocení); viz EU AI Act.
- Transparentnost: povinnost informovat uživatele, že komunikují s AI či že obsah je AI generovaný.
- Vysvětlitelnost (explainability): schopnost popsat, proč model rozhodl tak, jak rozhodl.
- Ochrana osobních údajů (GDPR): pravidla pro zpracování osobních údajů, která se vztahují i na AI; viz AI a ochrana osobních údajů (GDPR).
- Data poisoning (otrávení dat): útok vkládající škodlivá data do tréninku.
- Odpovědnost: otázka, kdo nese následky chyb AI; viz Kdo nese odpovědnost za chyby AI.
- Shadow AI: používání AI nástrojů zaměstnanci bez vědomí a schválení firmy; viz Firemní politika používání AI.
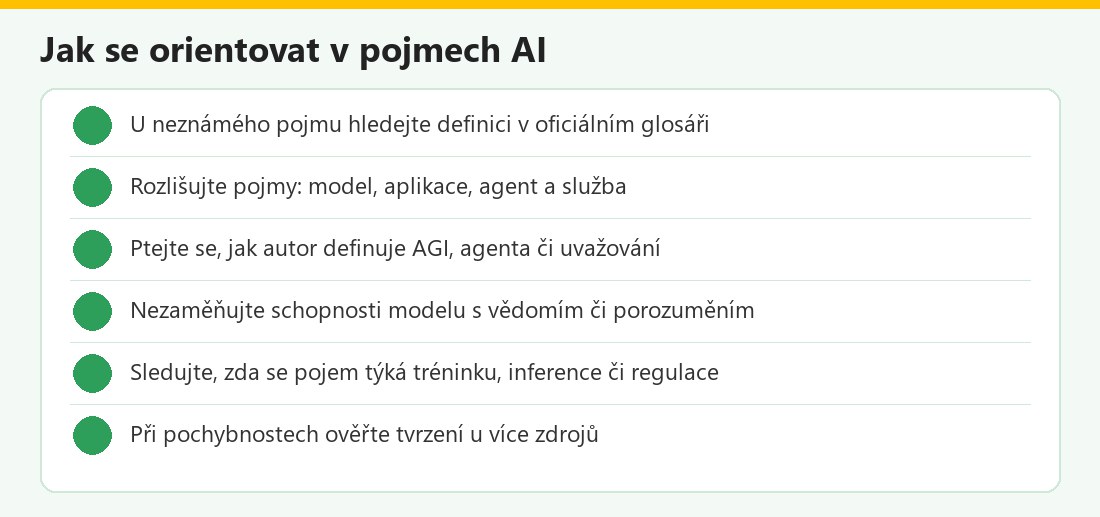 Kontrolní seznam – vlastní infografika
Časté otázky v praxi
Jaký je rozdíl mezi AI, modelem a chatbotem?: AI je obor, model je matematický systém, chatbot je aplikace, která model používá. Co je prompt?: zadání modelu. Co je token?: kousek textu, se kterým model počítá. Co je halucinace?: nepravdivá, ale věrohodná odpověď. Co je agent?: systém s modelem a nástroji plnící úkoly po krocích.
Slovník v kostce
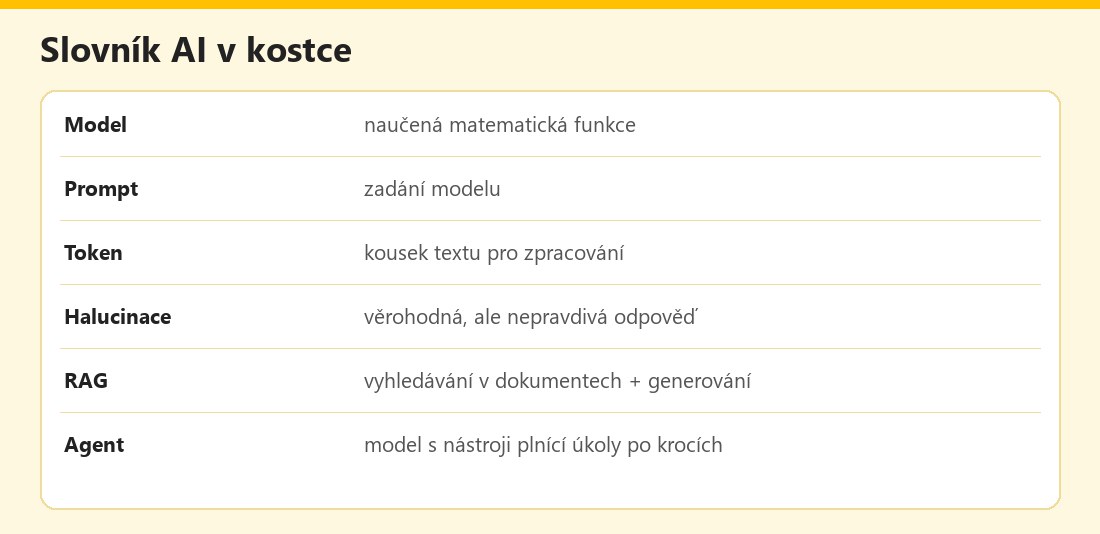 Základní údaje – vlastní infografika
Výhody a nevýhody
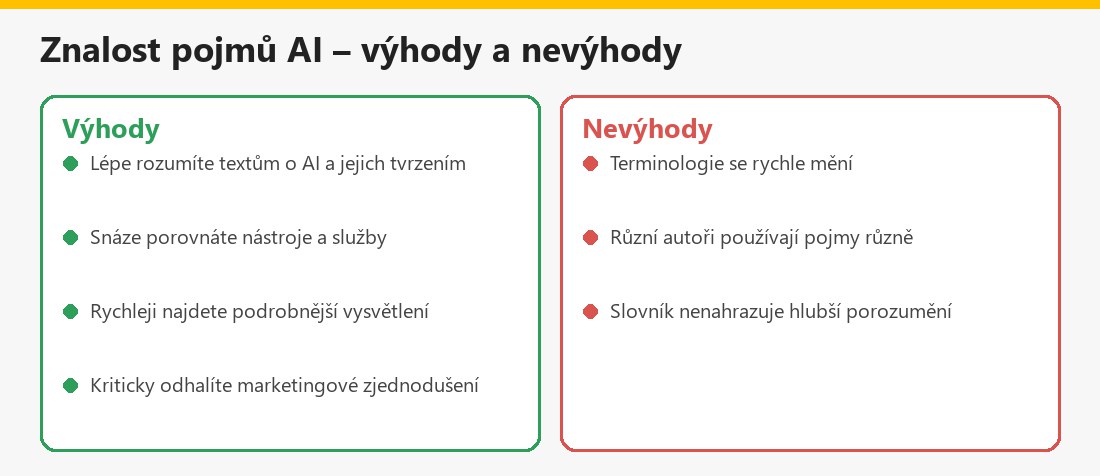 Souhrn pro čtenáře – vlastní infografika
Související články
Další články najdete v kategorii Základy a principy AI: Jak se trénuje AI model, Generativní AI vs. klasická AI, Multimodální AI a Jak hodnotit AI modely.
Shrnutí
Slovník shrnuje nejdůležitější pojmy umělé inteligence od agenta po zkreslení: model, prompt, token, kontextové okno, halucinace, RAG, fine-tuning, agent, multimodální či deepfake. Pojmy se vyvíjejí, proto si ověřujte, jak je používá konkrétní autor. Další vysvětlení najdete v Google ML Glossary a v souvisejících článcích.
Často kladené otázky ke slovníku AI
Co je LLM?
Velký jazykový model: neuronová síť natrénovaná na rozsáhlých textech, která umí generovat a zpracovávat jazyk.
Co je prompt?
Zadání, které dáváte modelu; kvalita zadání ovlivňuje kvalitu odpovědi.
Co je token?
Kousek textu, na který model text dělí a se kterým počítá.
Co je halucinace?
Věrohodně znějící, ale nepravdivá či vymyšlená odpověď modelu.
Co je RAG?
Vyhledání relevantních částí dokumentů a jejich vložení modelu pro odpověď se zdroji.
Co je agent?
Systém, který s pomocí modelu plánuje kroky a používá nástroje ke splnění úkolu.
Co je inference?
Použití natrénovaného modelu k vytvoření odpovědi.
Co je jailbreak?
Pokus o obejití bezpečnostních omezení modelu vhodným zadáním.
