
Tokeny a kontextové okno u AI – proč model „zapomíná“, proč je čeština dražší a jak s tím pracovat
Když chatbot odpoví, nepracuje s písmeny ani celými slovy, ale s malými kousky textu zvanými tokeny. A když si s ním povídáte dlouho, může se zdát, že na něco zapomněl: například na instrukci ze začátku konverzace. Obojí souvisí se dvěma základními pojmy, které stojí za to znát, i když AI používáte jen občas: tokeny a kontextové okno. Vysvětlují, proč se ceny API počítají „na tokeny“, proč je čeština nákladnější než angličtina, proč má každý model limit délky vstupu a výstupu a proč „větší okno“ ještě neznamená „dokonalou paměť“. Díky tomu lépe formulujete zadání, ušetříte peníze (u placených rozhraní) a nebudete překvapeni, když model dlouhý dokument zpracuje jen částečně.
V tomto článku vysvětlujeme, co je token a jak vzniká, proč čeština potřebuje víc tokenů, co je kontextové okno a co se do něj počítá, proč model „zapomíná“, co znamená dlouhý kontext v praxi, jak se tokeny promítají do ceny a rychlosti a jak se zadáním a dokumenty zacházet prakticky. Čerpáme z vysvětlení OpenAI: Understanding and counting tokens, FlowHunt: Token (slovník), HackerNoon: Váš chatbot nečte slova, ale počítá tokeny, dokumentace Anthropic: Context windows a Google: Long context a studie Lost in the Middle (anglicky). Konkrétní velikosti oken se u modelů často mění, proto je ověřte v dokumentaci poskytovatele.
Další články najdete v kategorii Základy a principy AI, například Jak funguje umělá inteligence, Strojové učení a hluboké učení a Proč AI halucinuje.
Aktualizováno: listopad 2026.
Co je token
Jazykový model je počítačový program a počítač pracuje s čísly. Aby model mohl zpracovat text, rozdělí jej na kousky (tokeny) a každému přiřadí číslo ze slovníku. Podle OpenAI může token být znak, část slova, celé slovo nebo interpunkční znaménko; rozhodnutí závisí na tom, jak často se danou posloupnost znaků v trénovacích datech vyskytovala. Příklady:
- Běžné krátké slovo („dům“, „the“) bývá jediný token.
- Dlouhé či vzácné slovo se rozdělí na několik tokenů („nepravděpodobnost“ → několik částí).
- Mezera, číslo, interpunkce a emoji mají vlastní tokeny, někdy více.
- Kód, matematika a neobvyklé znaky se obvykle tokenizují hůře než běžný text.
Každý model má vlastní tokenizér a slovník, takže stejný text může být u různých modelů různě dlouhý. Odhady typu „1 token ≈ 4 znaky či ¾ slova“ platí pro angličtinu zhruba, ale pro jiné jazyky neplatí. Počet tokenů svého textu zjistíte nástrojem, který nabízí poskytovatel modelu (například tokenizér OpenAI či počítadlo tokenů v dokumentaci jiných poskytovatelů).
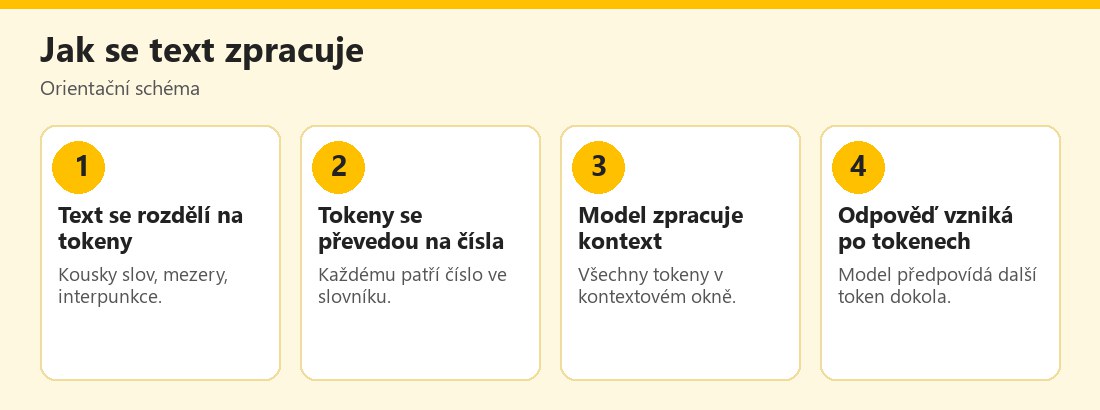 Orientační schéma zpracování textu jazykovým modelem – vlastní infografika
Proč čeština potřebuje víc tokenů
Slovníky tokenů vznikají z trénovacích dat, v nichž mají největší podíl angličtina a několik dalších velkých jazyků. Proto jsou anglické výrazy často celé jedním tokenem, kdežto české tvary (s diakritikou, pády a koncovkami) se častěji rozdělí na více kratších částí. Zdroje to potvrzují obecně: jazyky méně zastoupené v datech či s komplikovanějším písmem mohou vyžadovat víc tokenů na stejný význam. Důsledky:
- Vyšší náklady u placeného API (účtuje se za tokeny vstupu i výstupu).
- Rychlejší vyčerpání kontextového okna: stejné okno pojme v češtině kratší text než v angličtině.
- Delší latence (odpověď se generuje po tokenech).
- Menší prostor pro dokumenty a historii konverzace.
Rozdíl se mezi modely liší a novější tokenizéry českému textu obvykle vycházejí lépe. Pokud pracujete s API a velkými objemy textu, změřte skutečný počet tokenů u svého modelu. Nižší cena za milion tokenů navíc nemusí znamenat nižší celkové náklady, protože různé modely stejný text tokenizují odlišně.
Co je kontextové okno
Kontextové okno je maximální počet tokenů, které model dokáže zpracovat v jedné „sezení“: dohromady vstup (vaše zadání, historie konverzace, vložené dokumenty, systémové pokyny) i výstup (odpověď, kterou model vygeneruje). Podle dokumentace poskytovatelů se do okna počítá vše, nejen poslední zpráva. Představte si ho jako pracovní stůl s omezenou plochou: vejde se na něj jen určité množství papírů. Co se nevejde, model nevidí. Vlastnosti:
- Okno není trvalá paměť: po skončení konverzace (či při nové) model nemá přístup k předchozímu obsahu, pokud jej nezahrne produkt (funkce paměti, vyhledávání v historii).
- Velikost se liší podle modelu a časem roste; u některých dnešních modelů jde o stovky tisíc či miliony tokenů, ale konkrétní hodnoty ověřte v dokumentaci, protože se často mění.
- Výstup má vlastní limit: maximální délka odpovědi bývá menší než celé okno.
- Systémové pokyny a vložené nástroje zabírají část okna.
- Obrázky, zvuk a soubory se také převádějí na tokeny (viz Multimodální AI).
Model „nepamatuje“ předchozí konverzace sám od sebe: vidí jen to, co je právě v jeho okně. Funkce typu „paměť“ v chatbotech fungují tak, že aplikace vybrané informace znovu vloží do zadání; viz Paměť a nastavení soukromí v ChatGPT.
Proč model „zapomíná“
Při dlouhé konverzaci může dojít k několika jevům:
- Přetečení okna: když konverzace přesáhne limit, aplikace obvykle starší části zkrátí či vynechá (nebo je shrne). Model pak nevidí původní instrukci a odpovídá, jako by ji neznal.
- Zhoršená pozornost uprostřed: výzkumy (například studie „Lost in the Middle“) ukázaly, že modely hůře využívají informace uprostřed dlouhého vstupu než na začátku či na konci. Větší okno proto neznamená, že model spolehlivě využije všechno.
- Šum a rozptýlení: příliš mnoho nepodstatného textu snižuje kvalitu odpovědi.
- Konflikt pokynů: pozdější zpráva může přepsat dřívější; model bere v potaz vše a nemusí ctít původní pravidlo.
- Zvýšené náklady a latence: dlouhý vstup znamená více tokenů ke zpracování, tedy pomalejší a dražší odpověď.
Mylná představa zní: „když je okno dost velké, vložím tam všechno.“ Technicky to jde, ale kvalita odpovědi se u velmi dlouhých vstupů může zhoršit.
Jak s tím pracovat v praxi
- Důležité na začátek i na konec: klíčové pokyny a otázku dejte na jasné místo; u dlouhých vstupů je zopakujte na konci.
- Dlouhou konverzaci rozdělte: začněte novou konverzaci pro nové téma a vložte stručné shrnutí předchozích závěrů.
- Dokumenty zkraťte: vložte jen relevantní části; pro velké dokumenty využijte vyhledávání a výběr pasáží (RAG; viz RAG a fine-tuning).
- Strukturujte zadání: nadpisy, číslované kroky, jasně oddělené části („Dokument:“, „Úkol:“).
- Omezte zbytečný text: opakující se pozdravy, dlouhé formátování, nepodstatné pasáže.
- Ověřujte citace a čísla: model se může mýlit i s dokumentem v okně; viz Proč AI halucinuje.
- U API sledujte počet tokenů a ukládejte do mezipaměti opakující se části podle možností poskytovatele.
- Citlivé informace nevkládejte bez znalosti zásad zpracování; viz AI chatboti a soukromí dat.
- Dlouhé úlohy dělte na kroky: nejprve shrnutí kapitol, poté otázky.
- Používejte nástroje poskytovatele k odhadu počtu tokenů před odesláním.
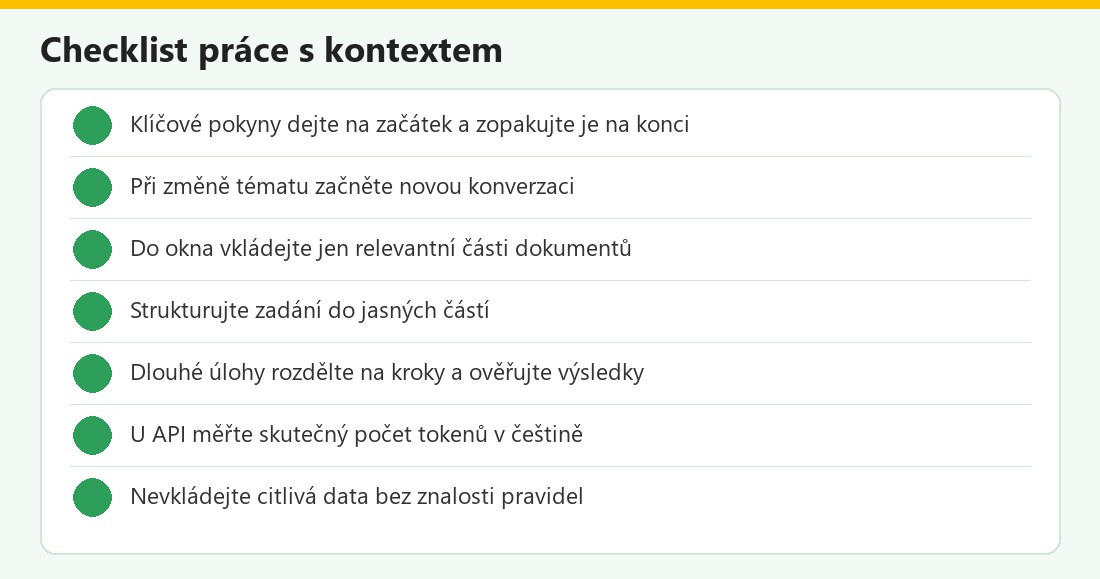 Kontrolní seznam – vlastní infografika
Tokeny, cena a rychlost
U placených rozhraní (API) se zpravidla účtuje za tokeny vstupu a výstupu (výstupní bývají dražší). Ve spotřebitelských aplikacích (chatbot s předplatným) platíte paušál, ale limity na počet zpráv či délku konverzace mají podobný důvod: výpočty stojí výkon. Praktické důsledky:
- Delší zadání = vyšší cena a pomalejší odpověď.
- Dlouhé odpovědi se generují postupně a trvají déle.
- Opakované vkládání stejné historie zvyšuje spotřebu; některé služby nabízejí „cache“ (zvýhodněné opakované použití prefixu).
- Různé modely mají různé ceny a tokenizéry; srovnávejte celkové náklady na reálném textu.
- Malé modely jsou levnější a rychlejší a pro jednoduché úlohy často stačí; viz Open-source AI modely.
Častá nedorozumění
- „Token = slovo“: není; slovo může být několik tokenů, a naopak.
- „Větší okno = lepší paměť“: ne vždy; kvalita využití se může u dlouhého vstupu snižovat.
- „Model si mě pamatuje“: bez funkce paměti ne; vidí jen aktuální okno.
- „Čeština a angličtina stojí stejně“: čeština obvykle spotřebuje víc tokenů.
- „Odpověď se nevešla, tak je model hloupý“: mohl narazit na limit výstupu.
- „Mohu vložit celou knihu“: záleží na modelu; i tak je lepší vybírat relevantní části.
Firmy a vývojáři
Firmy, které AI nasazují, musí počítat s náklady na tokeny, limity kontextu a latencí: navrhovat zadání úsporně, využívat vyhledávání v dokumentech místo vkládání všeho, měřit spotřebu, nastavit limity a monitoring, chránit citlivá data a ověřovat výsledky. Viz AI v práci: jak efektivně a bezpečně využívat ChatGPT a Firemní politika používání AI.
Tokeny a kontext v kostce
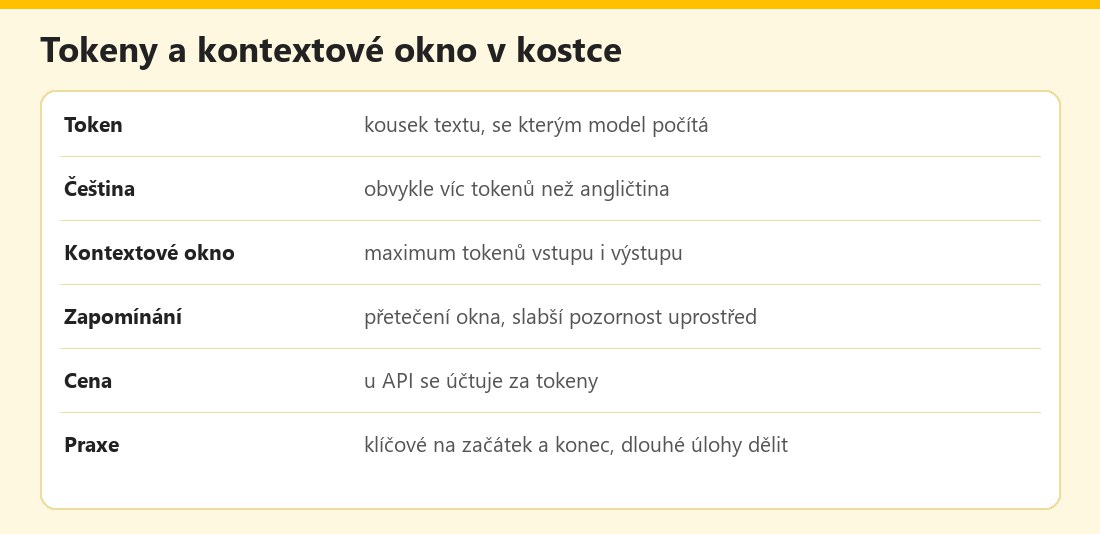 Základní údaje – vlastní infografika
Výhody a nevýhody
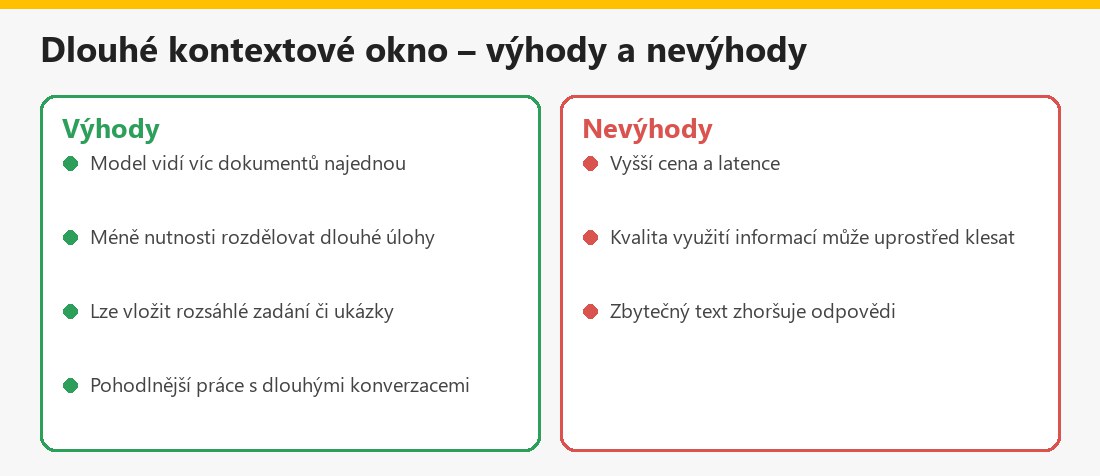 Souhrn pro uživatele AI – vlastní infografika
Související články
Další články najdete v kategorii Základy a principy AI: Jak se trénuje AI model, RAG a fine-tuning, Multimodální AI a Jak psát prompty pro AI.
Shrnutí
Tokeny jsou kousky textu, s nimiž jazykový model počítá; čeština jich obvykle spotřebuje víc než angličtina. Kontextové okno je limit tokenů vstupu i výstupu a není to trvalá paměť. Při dlouhých konverzacích model může zapomínat, proto dávejte důležité pokyny na začátek a konec, dělte úlohy a vkládejte jen relevantní text. Více najdete v dokumentaci Anthropic a Google.
Často kladené otázky k tokenům a kontextovému oknu
Co je token?
Kousek textu (znak, část slova, slovo či interpunkce), na které model text dělí a s nimiž počítá.
Proč čeština spotřebuje víc tokenů?
Slovníky vznikají hlavně z angličtiny, takže české tvary se častěji dělí na více částí.
Co je kontextové okno?
Maximální počet tokenů vstupu i výstupu, které model zpracuje najednou.
Proč chatbot zapomíná?
Starší část konverzace se vyhodí z okna a modely navíc hůře využívají informace uprostřed dlouhého vstupu.
Je kontextové okno paměť?
Ne; je to jen aktuální vstup. Paměť v aplikacích funguje tak, že se vybrané informace vkládají znovu.
Jak zjistit počet tokenů?
Nástrojem poskytovatele modelu (tokenizér či počítadlo tokenů); různé modely tokenizují odlišně.
Mám do okna vkládat všechno?
Raději jen relevantní části; příliš dlouhý a zbytečný vstup zhoršuje kvalitu a zvyšuje cenu.
Jak ovlivňují tokeny cenu?
U API se účtují tokeny vstupu i výstupu; delší text a dražší model znamenají vyšší náklady.
