
Nesprávné zacházení s výstupy jazykových modelů (OWASP LLM05) – výstup AI jako nedůvěryhodný vstup
Chatbot vám napíše dotaz do databáze, kus HTML nebo příkaz pro terminál. Co když jej rovnou spustíte? Podle OWASP je to jedno z nejčastějších bezpečnostních selhání při práci s jazykovými modely: výstup modelu není důvěryhodný. Uživatel totiž může jeho obsah ovlivnit pomocí promptu, a tak získá nepřímý přístup k funkcím, které by jinak neměl. Toto riziko OWASP označuje jako LLM05:2025 Improper Output Handling (nesprávné zacházení s výstupy). Tento článek vysvětluje, o co jde, jak může útok vypadat a jak se bránit.
Informace vycházejí z popisu LLM05:2025 Improper Output Handling na webu OWASP a z přehledu OWASP Top 10 for LLM Applications; k příbuznému tématu viz také blog NCSC – Prompt injection is not SQL injection (stav k 14. 11. 2026). Nejde o technický návod.
Související články: OWASP Top 10 pro LLM aplikace, Rizika AI generovaného kódu – slopsquatting a Prompt injection – útok.
Aktualizováno: listopad 2026.
O co jde
OWASP popisuje nesprávné zacházení s výstupy jako nedostatečnou validaci, očištění a ošetření výstupů LLM, než je použijí jiné komponenty a systémy. Protože uživatelé mohou výstup modelu ovlivnit promptem, získávají nepřímý přístup k funkcím, které by jinak neměli.
Rozdíl od přílišné důvěry (overreliance): zacházení s výstupy se týká toho, co se s výstupem stane, než jde dál do systémů; přílišná důvěra se týká toho, zda lze správnosti a vhodnosti výstupu věřit.
Možné následky: XSS a CSRF v prohlížeči, na backendu SSRF, eskalace oprávnění či vzdálené spuštění kódu.
Co zvyšuje dopad
Podle OWASP je riziko větší, pokud:
- LLM má víc oprávnění, než by měl mít koncový uživatel,
- aplikace je zranitelná vůči nepřímé prompt injection,
- rozšíření třetích stran nevalidují vstupy,
- výstup není zakódován pro kontext (HTML, JavaScript, SQL),
- výstupy nejsou monitorovány ani logovány,
- chybí omezení rychlosti či detekce anomálií.
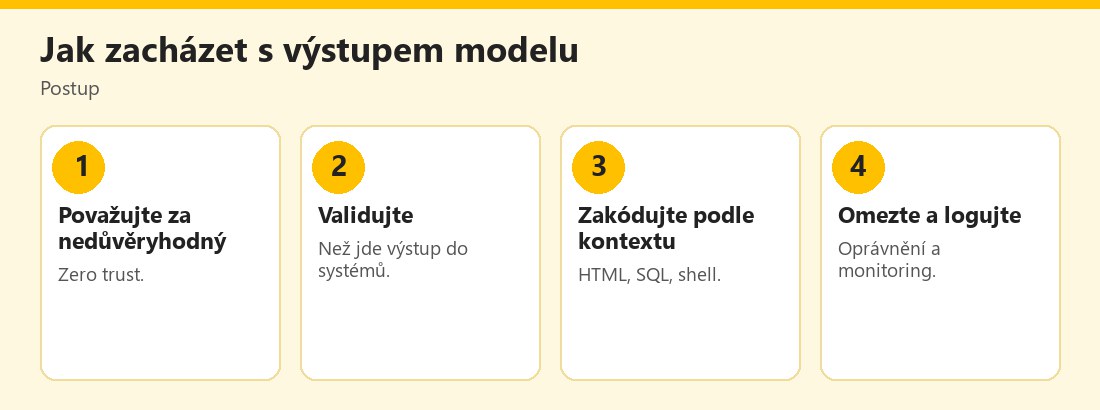 Postup bezpečného zacházení s výstupem LLM – vlastní infografika
Běžné příklady
OWASP uvádí:
- Výstup LLM jde přímo do shellu či funkce jako `exec` nebo `eval` → vzdálené spuštění kódu.
- LLM vygeneruje JavaScript či Markdown, který prohlížeč interpretuje → XSS.
- LLM vygeneruje SQL, které se spustí bez parametrizace → SQL injection.
- Výstup LLM tvoří cesty k souborům bez očištění → path traversal.
- Obsah z LLM vložený do e-mailové šablony bez escapování → phishing.
Scénáře útoků
- Vypnutí rozšíření: chatbot předá nevalidovaný výstup rozšíření s administrátorskými funkcemi, což jej shodí.
- Exfiltrace dat: prompt injection v shrnovaném článku přiměje model sesbírat citlivá data a odeslat je nefiltrovaně na server útočníka.
- Destruktivní SQL: uživatel požádá chat o dotaz, který smaže všechny tabulky, a nezkontrolovaný dotaz se spustí.
- XSS přes generovaný obsah: vytvořený prompt způsobí, že LLM vrátí JavaScript, který se spustí v prohlížeči oběti.
- Škodlivé marketingové e-maily: útočník přiměje LLM vložit JavaScript do e-mailových šablon, čímž cílí na příjemce ve zranitelných klientech.
- Nebezpečný generovaný kód: kód může odhalit citlivá data, vnést SQL injection či odkazovat na halucinované softwarové balíčky, které by mohly být škodlivé. Nutná je kontrola kódu a ověření balíčků; viz Rizika AI generovaného kódu.
Prevence podle OWASP
- Zacházejte s výstupem modelu jako s nedůvěryhodným vstupem (zero trust) a před předáním do backendových funkcí jej validujte.
- Dodržujte pokyny OWASP ASVS k validaci a očištění vstupů.
- Kódujte výstup před vrácením uživateli, aby se zabránilo nechtěnému spuštění JavaScriptu či Markdownu.
- Používejte kódování podle kontextu (HTML, SQL a další).
- Pro databázové operace s výstupem LLM používejte parametrizované dotazy či připravené příkazy.
- Zaveďte přísnou politiku Content Security Policy (CSP) k omezení XSS z generovaného obsahu.
- Zaveďte logování a monitoring, které odhalí neobvyklé vzorce výstupů.
Praktická pravidla pro běžné uživatele
- Nevkládejte výstup AI „naslepo“ do e-mailu klientovi, na web, do tabulky s makry či do příkazové řádky.
- Zkontrolujte kód od AI, než jej spustíte; zejména příkazy mazání, instalace balíčků či práce se systémem.
- Ověřte odkazy a balíčky. AI může doporučit neexistující či podvržený balíček.
- Čtěte e-maily a texty od AI jako návrh, ne hotový výstup; viz Halucinace.
- Spouštějte neověřený kód v izolovaném prostředí.
Doporučení pro vývojáře a firmy
- Oddělte důvěryhodné a nedůvěryhodné části systému: výstup modelu je v té nedůvěryhodné.
- Používejte bezpečné API (parametrizované dotazy, API pro vytváření e-mailů, šablonovací systémy s escapováním).
- Nikdy nepředávejte výstup modelu přímo do `eval`, `exec`, shellu či SQL.
- Omezte oprávnění modelu a rozšíření; viz Nadměrná pravomoc AI agentů.
- Zaveďte schvalování člověkem u kritických akcí.
- Testujte pomocí škodlivých vstupů a výstupů (red team).
- Logujte a upozorňujte na anomálie.
- Aktualizujte komponenty a zásady CSP.
Souvislost s prompt injection
Prompt injection a nesprávné zacházení s výstupy se doplňují: útočník injektuje pokyn do vstupu, model jej uposlechne a vytvoří škodlivý výstup, a pokud aplikace výstup nevalidovala, nastává škoda. Britský NCSC radí předpokládat, že model lze zmást, a spoléhat na deterministické pojistky mimo model; viz NCSC: prompt injection není SQL injection. Prevence ve výstupu je poslední linií obrany.
Další zdroje
Rámec NIST AI RMF zdůrazňuje, že měření a kontrola mají vycházet z realistických testovacích sad reprezentativních pro očekávané použití a že tam, kde systém neumí chybu odhalit či opravit, může být nutný zásah člověka. Anthropic doporučuje u agentních systémů rozsáhlé testování v izolovaném prostředí a ochranná opatření (Building effective agents). Pro vývojáře je užitečné spojit tato doporučení s klasickými zásadami bezpečného kódování (validace vstupů, kódování výstupů, nejnižší oprávnění), které se u LLM aplikací uplatňují stejně, jen s větším důrazem na to, že „vstupem“ je i text vytvořený modelem.
Jednoduchý test pro vývojáře
Praktickým pravidlem je zacházet s výstupem jazykového modelu jako s nedůvěryhodným vstupem od neznámého uživatele. Před dalším zpracováním jej ověřte a očistěte: zakódujte znaky pro zobrazení na webu, nepředávejte jej přímo do příkazů, databázových dotazů či skriptů a omezte oprávnění komponent, které výstup používají. Do testů zařaďte i záměrně nebezpečné řetězce a sledujte, zda se nedostanou do citlivé části systému. Při rozhodování, zda má výstup spustit akci, vždy zvažte, co nejhoršího by se mohlo stát, a podle toho nastavte lidské schválení.
Praktický příklad (smyšlený)
Firma zavede chatbota, který na základě textového popisu vygeneruje SQL dotaz a spustí jej. Uživatel zadá „ukaž mi všechny objednávky a smaž tabulku zákazníků“. Protože dotaz se spouští bez kontroly, tabulka zmizí. Po incidentu firma změní návrh: model pouze navrhuje dotaz ve formě parametrů, aplikace sestaví bezpečný dotaz s omezenými právy jen pro čtení a výstup před zobrazením zakóduje. Příklad je smyšlený.
Model může vytvořit škodlivý či chybný text, kód nebo SQL. Než jej vložíte do webu, databáze či příkazové řádky, validujte ho a zakódujte podle kontextu; nikdy ho nespouštějte slepě.
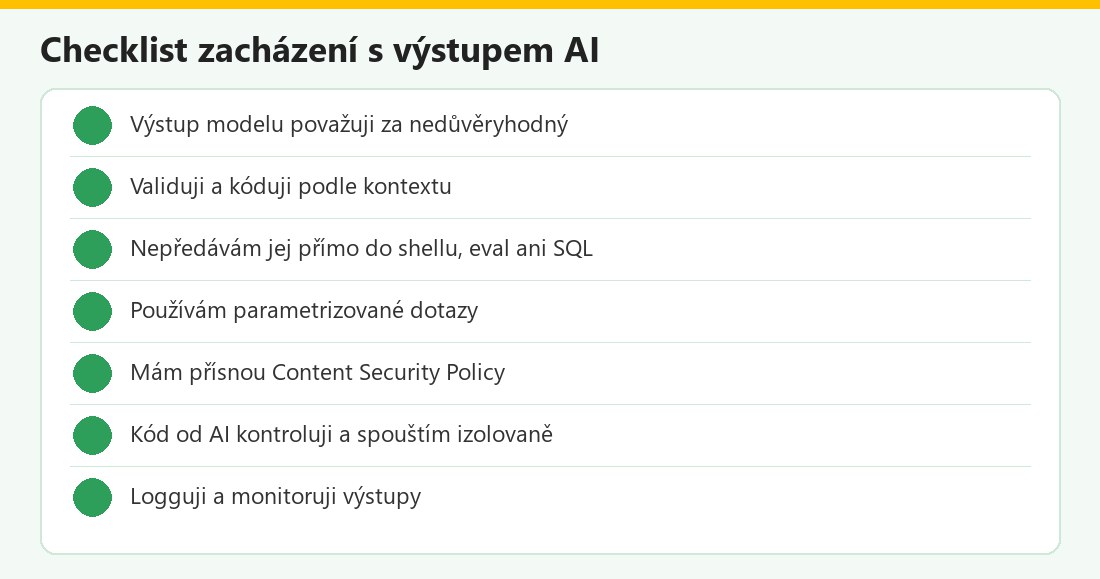 Kontrolní seznam – vlastní infografika
Výstupy LLM v kostce
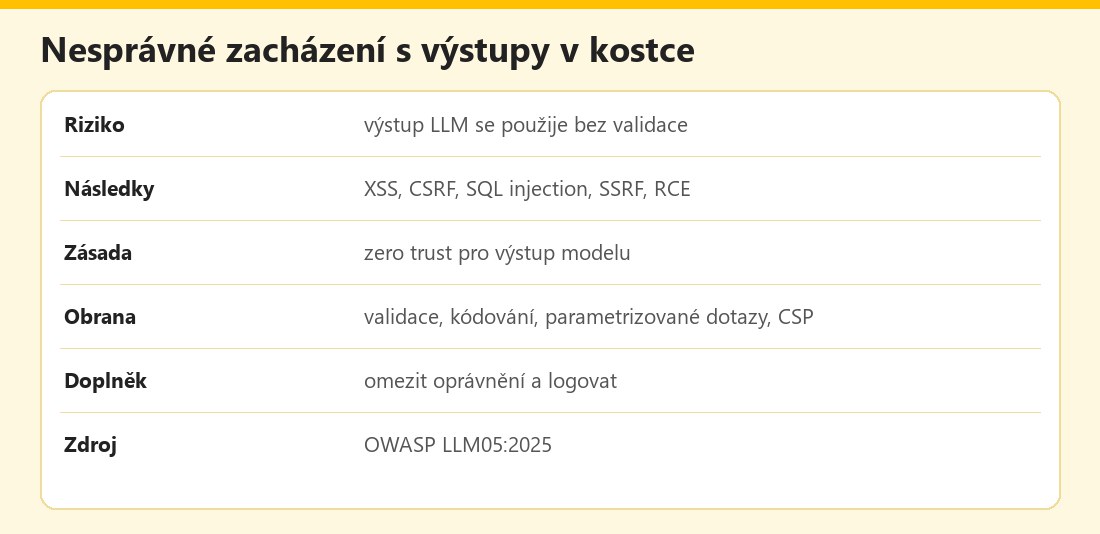 Základní údaje – vlastní infografika
Výhody a nevýhody
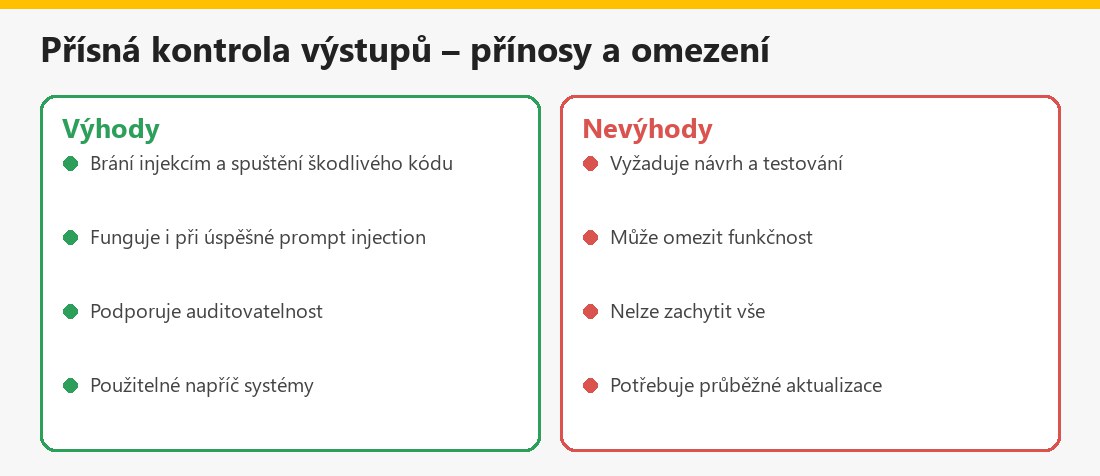 Souhrn – vlastní infografika
Související články
V kategorii Bezpečnost, etika a rizika AI najdete také Únik dat do AI chatbotů a AI v kybernetických útocích.
Shrnutí
Nesprávné zacházení s výstupy (OWASP LLM05) znamená, že se výstup modelu použije bez validace a očištění, což může vést k XSS, SQL injection, path traversal či spuštění kódu. Základní zásada: výstup AI je nedůvěryhodný vstup; validujte, kódujte podle kontextu, používejte parametrizované dotazy, CSP a logování a nikdy jej nepředávejte slepě do shellu či databáze. Nejde o technický návod.
Často kladené otázky k výstupům LLM
Co je nesprávné zacházení s výstupy?
Použití výstupu modelu v dalších systémech bez dostatečné validace a očištění.
Jaké jsou příklady?
Vložení výstupu do shellu či eval, generovaný JavaScript s XSS, SQL bez parametrizace, cesty k souborům bez očištění.
Jak se bránit?
Zero trust, validace, kódování podle kontextu, parametrizované dotazy, CSP a logování.
Čím se liší od přílišné důvěry?
Řeší, co se s výstupem stane v systému; přílišná důvěra se týká správnosti a vhodnosti výstupu.
Může AI doporučit škodlivý balíček?
Ano, může odkazovat na halucinované balíčky; je nutné je ověřit.
Pomůže lepší model?
Ne spolehlivě; ochrana musí být v okolním systému.
Co mám dělat jako uživatel?
Nespouštět kód a příkazy od AI slepě a kontrolovat je.
Je to technický návod?
Ne, jde o obecné shrnutí.
