
OWASP Top 10 pro aplikace s LLM (2025) – deset hlavních bezpečnostních rizik srozumitelně
Firmy, školy i vývojáři dnes připojují jazykové modely k e-mailu, dokumentům, databázím a platbám. Každé takové propojení otevírá nová bezpečnostní rizika. Komunita OWASP, která dlouhodobě vydává žebříčky rizik pro webové aplikace, proto vytvořila OWASP Top 10 pro aplikace s LLM (verze 2025). Tento článek shrnuje všech deset rizik srozumitelně, vysvětluje, co znamenají v praxi, a odkazuje na články, které se jim věnují podrobněji.
Informace vycházejí z přehledu OWASP Top 10 for LLM Applications a ze stránek jednotlivých rizik na genai.owasp.org (stav k 14. 11. 2026). Anglické názvy jsou zachovány v závorkách pro snazší dohledání. Nejde o technický ani právní návod.
Související články: Prompt injection – útok, AI agenti a bezpečnostní rizika a Únik dat do AI chatbotů.
Aktualizováno: listopad 2026.
Deset rizik v kostce
1. Prompt injection (LLM01). Vstup uživatele (nebo vložený obsah) může změnit chování modelu nechtěným způsobem a přebít původní instrukce. Podrobně viz Prompt injection a NCSC: prompt injection není SQL injection.
2. Sensitive Information Disclosure – únik citlivých informací (LLM02). Model nebo aplikace může odhalit soukromá, vlastnická či důvěrná data. Viz Únik dat do AI chatbotů.
3. Supply Chain – dodavatelský řetězec (LLM03). Slabiny v modelech, datových sadách, komponentách či pluginech třetích stran mohou do systému přinést riziko.
4. Data and Model Poisoning – otrava dat a modelů (LLM04). Zmanipulovaná data pro předtrénink, doladění či embeddingy mohou narušit integritu a chování modelu. Viz Otrava dat a modelů.
5. Improper Output Handling – nesprávné zacházení s výstupy (LLM05). Pokud se výstupy modelu předávají dál bez kontroly a očištění, mohou umožnit útoky typu injekce. Viz Nesprávné zacházení s výstupy.
6. Excessive Agency – nadměrná pravomoc (LLM06). Přílišné funkce, oprávnění či autonomie může modelu umožnit škodlivé akce. Viz Nadměrná pravomoc AI agentů.
7. System Prompt Leakage – únik systémového promptu (LLM07). Skryté instrukce mohou odhalit citlivou logiku nebo vložená tajemství. Viz Únik systémového promptu.
8. Vector and Embedding Weaknesses – slabiny vektorů a embeddingů (LLM08). Chyby v tom, jak se vektory vytvářejí, ukládají a vyhledávají, lze zneužít u systémů založených na vyhledávání (RAG). Viz Embeddingy a vektorové vyhledávání.
9. Misinformation – dezinformace (LLM09). Modely mohou vytvářet nepravdivý či zavádějící obsah, kterému lidé uvěří. Viz Halucinace a Dezinformace a AI propaganda.
10. Unbounded Consumption – neomezená spotřeba (LLM10). Nekontrolované využívání zdrojů (například nadměrný počet dotazů) může způsobit překročení nákladů, zhoršení služby či výpadek.
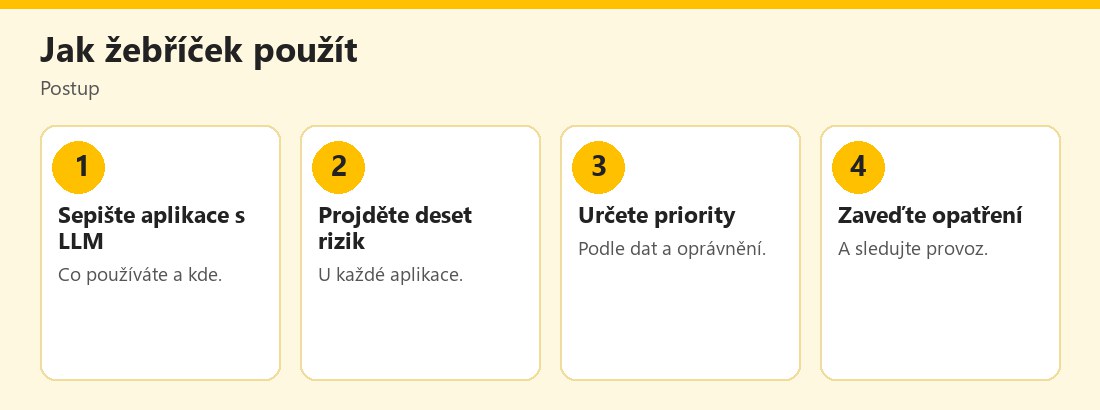 Postup použití OWASP Top 10 pro LLM – vlastní infografika
Co z toho plyne pro uživatele
- Neposkytujte modelu víc, než je nutné. Čím víc práv a údajů, tím větší škoda při chybě či útoku.
- Nepřijímejte výstupy slepě. Dezinformace a nesprávné výstupy jsou běžné.
- Pozor na nástroje, které „samy jednají“. Agent s přístupem k e-mailu či platbám je vyšší riziko; viz AI agenti a bezpečnostní rizika.
- Nevkládejte citlivé údaje do chatbotů, pokud nevíte, jak se zpracovávají.
- Používejte důvěryhodné aplikace a aktualizace.
Co z toho plyne pro firmy a vývojáře
- Inventář. Zjistěte, kde se LLM používají (včetně „stínových“ nástrojů zaměstnanců).
- Princip nejmenších oprávnění. Modelu dejte jen nezbytné funkce a práva.
- Nedůvěřujte výstupům modelu. Ošetřete je jako nedůvěryhodný vstup.
- Neukládejte tajemství do promptů.
- Ověřte dodavatele modelů, dat a pluginů.
- Chraňte data pro RAG (přístupová práva, kontrola obsahu).
- Omezte spotřebu (limity, kvóty, upozornění na náklady).
- Logujte a monitorujte: vstupy, výstupy, volání nástrojů.
- Testujte (včetně „red teamingu“) a pravidelně aktualizujte.
- Dokumentujte a řiďte rizika podle rámce, například NIST AI RMF.
Společné téma: nedůvěřuj modelu
Pokud z žebříčku plyne jedna zásada, pak tato: model je „nejistý spolupracovník“. Může se mýlit, může být oklamán a může být zneužit. Proto se bezpečnost nemá spoléhat jen na instrukce v promptu, ale na nezávislé, předvídatelné kontroly v okolním systému: oprávnění, validaci, schvalování lidmi, limity a monitoring. Stejné poučení vyplývá i z doporučení britského NCSC o prompt injection a z rámce NIST; viz NCSC: prompt injection není SQL injection.
Kde najít další informace
Podrobné popisy jednotlivých rizik s doporučeními najdete na stránkách OWASP, například Excessive Agency, System Prompt Leakage, Data and Model Poisoning a Improper Output Handling. Britské NCSC upozorňuje, že prompt injection nelze úplně odstranit jako klasickou SQL injection a doporučuje navrhovat systémy tak, aby zvládly „zmateného“ modela: Prompt injection is not SQL injection. Systematické řízení rizik AI popisuje rámec NIST AI RMF.
Jak začít v malé organizaci
Nemusíte hned pracovat se všemi deseti riziky. Pro malou organizaci stačí začít třemi kroky: zaprvé sepište všechny nástroje s AI, které se používají (včetně těch, které si zaměstnanci zavedli sami); zadruhé u každého určete, jaká data zpracovává a jaká oprávnění má (čte e-maily? může odesílat? přistupuje k databázi?); zatřetí nastavte pravidla: co nikdy nevkládat, kdo schvaluje nové nástroje, jak se hlásí podezřelé chování. Pokud nástroj může provádět akce (psát zprávy, měnit data, platit), nastavte potvrzování člověkem. Teprve potom se pouštějte do složitějších opatření, například testování útoků či monitoringu.
Kde se žebříček míjí s realitou
OWASP je technický žebříček, který nepokrývá všechna rizika AI: například zkreslení a diskriminaci, autorská práva, dopady na zaměstnanost či zneužití AI k podvodům. Pro tato témata viz Rizika AI – bias a diskriminace, Etika AI a autorská práva a Podvody s AI – phishing a vishing. V Evropě navíc platí regulace AI Act; viz AI Act – harmonogram.
Jak začít s přehledem rizik v praxi
Seznam rizik není kontrolní seznam, který stačí odškrtnout, ale pomůcka pro přemýšlení. Prvním krokem je zmapovat, kde se ve firmě či projektu jazykové modely skutečně používají, jaká data dostávají a jaké akce mohou spouštět. Potom ke každému případu použití přiřaďte nejpravděpodobnější rizika a rozhodněte, která opatření jsou přiměřená: omezení oprávnění, filtrování vstupů a výstupů, lidské schvalování rizikových akcí, záznamy a testování. Seznam pravidelně aktualizujte, protože se mění technologie i způsoby útoků, a nepovažujte jej za úplný popis všech hrozeb.
Praktický příklad (smyšlený)
Malá firma zavede chatbota, který čte e-maily zákazníků a navrhuje odpovědi. Podle žebříčku zjistí tři rizika: chatbot má právo odesílat e-maily (nadměrná pravomoc), v systémovém promptu je přístupový klíč k databázi (únik promptu) a odpovědi se vkládají přímo do e-mailových šablon (nesprávné zacházení s výstupy). Firma odebere právo odesílání (každý koncept schvaluje člověk), klíč přesune do bezpečného úložiště a výstupy před vložením očistí. Příklad je smyšlený.
OWASP Top 10 pro LLM shrnuje deset rizik od prompt injection po neomezenou spotřebu. Základní zásada: omezte oprávnění, nedůvěřujte výstupům, neukládejte tajemství do promptů a kontrolu zajistěte mimo model.
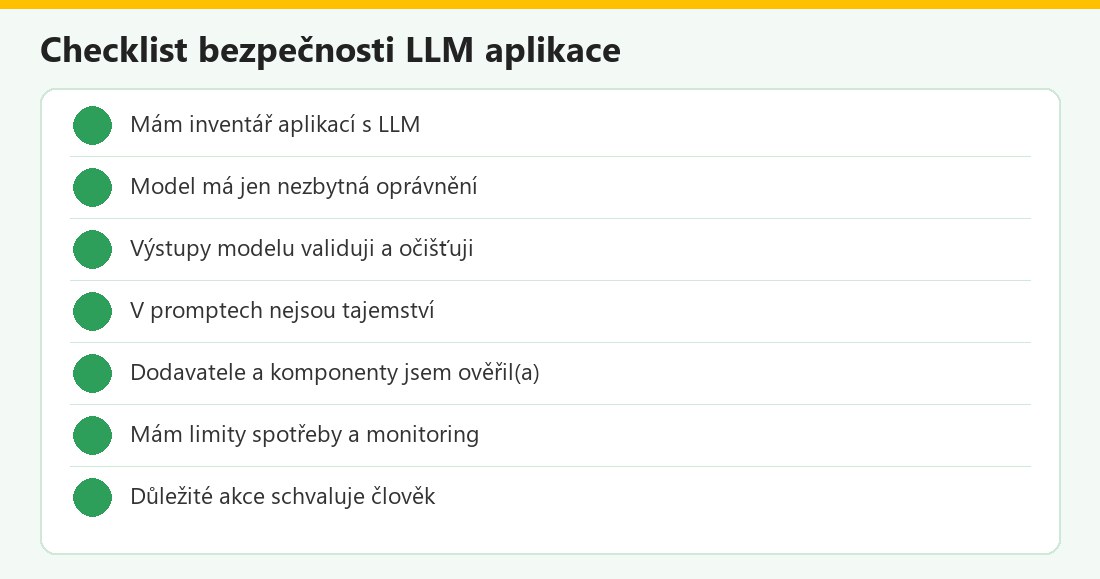 Kontrolní seznam – vlastní infografika
OWASP Top 10 v kostce
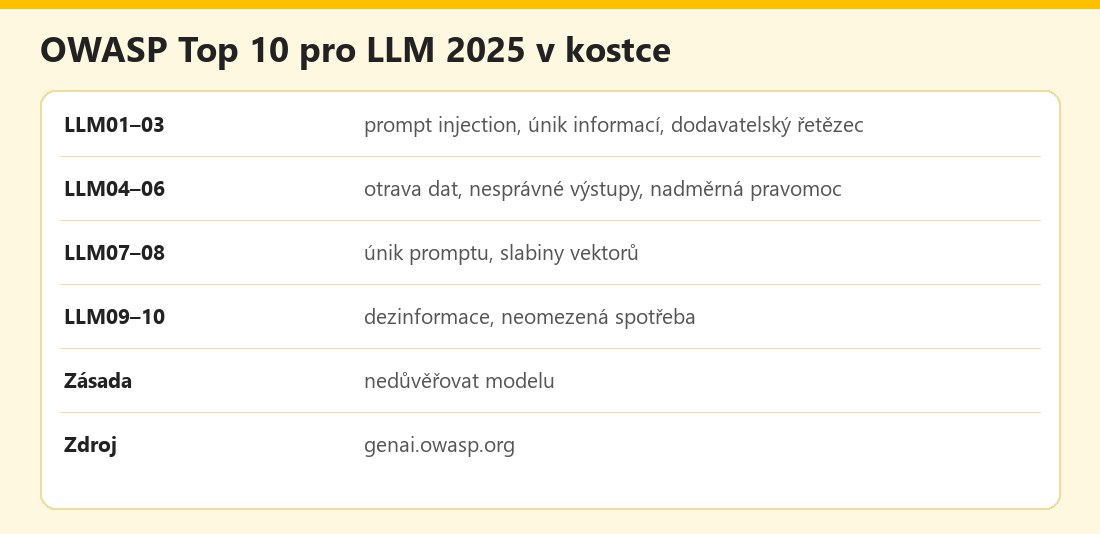 Základní údaje – vlastní infografika
Výhody a nevýhody
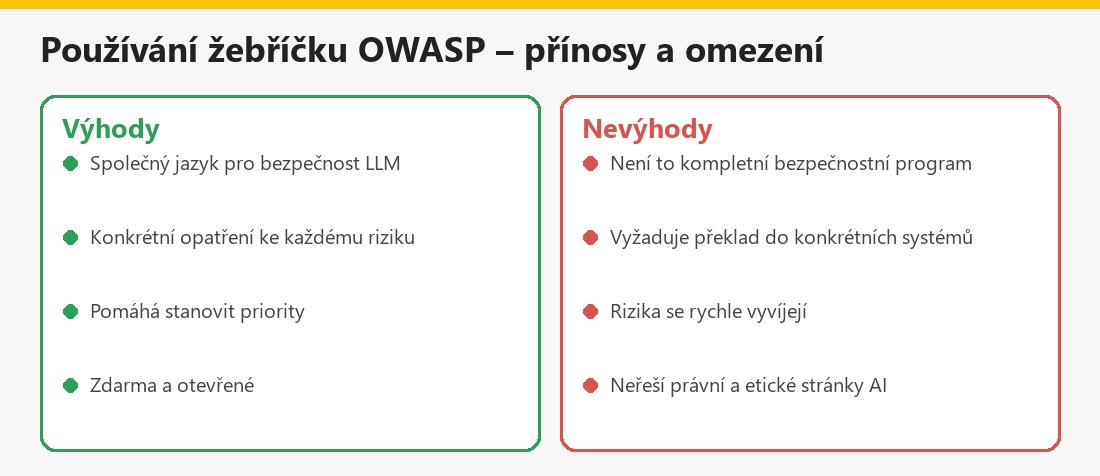 Souhrn – vlastní infografika
Související články
V kategorii Bezpečnost, etika a rizika AI najdete také Bezpečné používání AI – checklist a Jailbreak AI modelů.
Shrnutí
OWASP Top 10 pro LLM aplikace 2025 uvádí: prompt injection, únik citlivých informací, dodavatelský řetězec, otravu dat a modelů, nesprávné zacházení s výstupy, nadměrnou pravomoc, únik systémového promptu, slabiny vektorů a embeddingů, dezinformace a neomezenou spotřebu. Společné poučení: nedůvěřuj modelu; omezte oprávnění, ošetřete výstupy, neukládejte tajemství do promptů a zajistěte kontrolu mimo model. Nejde o technický návod.
Často kladené otázky k OWASP Top 10 pro LLM
Co je OWASP Top 10 pro LLM?
Žebříček deseti nejvýznamnějších bezpečnostních rizik pro aplikace s jazykovými modely (verze 2025).
Které riziko je první?
Prompt injection (LLM01).
Co je nadměrná pravomoc?
Situace, kdy má model příliš mnoho funkcí, oprávnění či autonomie a může provést škodlivé akce.
Co je otrava dat?
Manipulace s daty pro trénink, doladění či embeddingy, která poškodí integritu modelu.
Proč nedávat tajemství do promptu?
Systémový prompt může uniknout a odhalit klíče či logiku.
Co je neomezená spotřeba?
Nekontrolované využívání zdrojů, které způsobí vysoké náklady či výpadek služby.
Pro koho je žebříček určen?
Pro vývojáře, bezpečnostní týmy i firmy, které LLM nasazují.
Je to technický návod?
Ne, jde o obecný přehled.
