
Jak se trénuje AI model – předtrénování, instrukční ladění a lidská zpětná vazba (RLHF)
Chatbot, který vám odpoví na dotaz, se nerodí „hotový“. Prošel několika fázemi tréninku, při kterých z obrovského množství textu (a často i obrázků, zvuku a kódu) získal schopnost psát, shrnovat a odpovídat. Pochopit tyto fáze pomáhá odpovědět na otázky, které si klade každý uživatel: Odkud model ví, co ví? Proč se někdy mýlí? Proč odpovídá zdvořile a „asistentsky“? Proč neví o událostech po určitém datu? A co je vlastně na datech, na kterých se učil? Odpovědi souvisí s tím, jak se trénink dělí na hlavní etapy: předtrénování, instrukční ladění a dolaďování podle lidských preferencí.
V tomto článku vysvětlujeme, jak vypadají data pro trénink, co se děje při předtrénování, jak se model učí následovat pokyny (instrukční ladění), jak funguje lidská zpětná vazba (RLHF), jak se modely testují a zabezpečují, proč trénink stojí tolik, proč model „neví“ nejnovější události a jaké otázky vyvolávají data (autorská práva, soukromí). Čerpáme z přehledů A Survey of Large Language Models, A Survey on Post-training of Large Language Models, studie OpenAI Training language models to follow instructions with human feedback, publikací Language Models are Few-Shot Learners a Training Compute-Optimal Large Language Models a výukových materiálů Aalto University a BYU-Idaho (anglicky). Konkrétní postupy výrobců se liší a často nejsou zveřejněny; popisujeme obecný model.
Další články najdete v kategorii Základy a principy AI, například Jak funguje umělá inteligence, Strojové učení a hluboké učení a Tokeny a kontextové okno.
Aktualizováno: listopad 2026.
Přehled fází
Velké jazykové modely se obvykle vytvářejí ve třech hlavních krocích:
- Předtrénování (pre-training): model se na obrovském korpusu textu učí předpovídat následující token; získává jazyk, znalosti a vzorce.
- Instrukční ladění (supervised fine-tuning, SFT): dotrénování na menším, kurátorovaném souboru zadání a vzorových odpovědí, aby model reagoval na pokyny jako asistent.
- Dolaďování podle lidských preferencí (RLHF a podobné metody): lidé hodnotí odpovědi, z hodnocení vznikne model odměny a samotný model se upravuje tak, aby generoval odpovědi, které lidé preferují (užitečné, srozumitelné, bezpečné).
Mezi tím a po něm následují vyhodnocení, bezpečnostní testy a nasazení. Kromě toho vznikají specializované verze (pro kód, pro matematiku, pro obrázky) a menší modely zjednodušené z velkých.
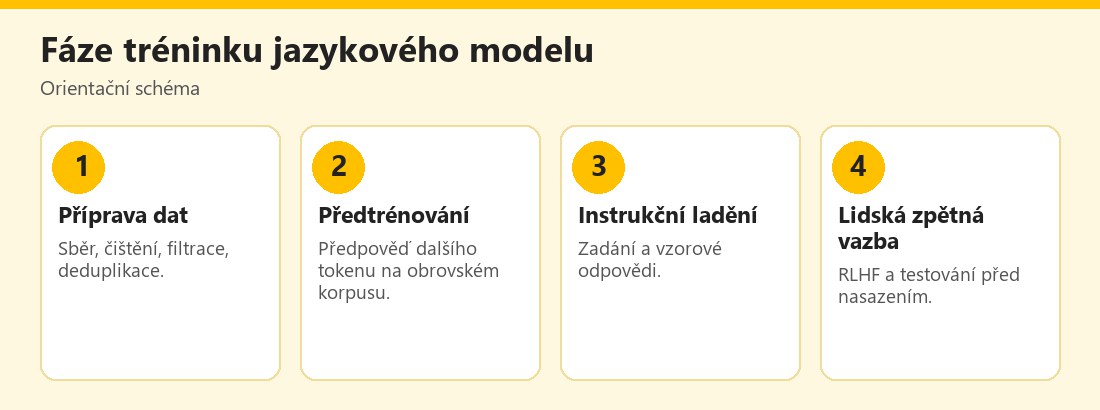 Orientační schéma tréninku jazykového modelu – vlastní infografika
Data: z čeho se model učí
Trénovací data určují, co model „ví“ a jak se chová. Obvykle zahrnují:
- Veřejné webové stránky (filtrované), knihy, články, vědecké práce, encyklopedie.
- Zdrojový kód a technická dokumentace.
- Diskuse a dialogy (po filtraci).
- Vícejazyčné texty; podíl jazyků ovlivňuje kvalitu v nich (angličtina bývá nejsilnější).
- Licencovaná a vlastní data (smlouvy s vydavateli).
- Syntetická data vytvořená jinými modely.
- Obrázky, zvuk, video u multimodálních modelů; viz Multimodální AI.
Před tréninkem se data čistí a filtrují: odstraňují se duplicity, spam, nekvalitní či škodlivý obsah, osobní údaje (částečně) a text ve špatném formátu; rozhoduje se o poměrech zdrojů. Kvalita dat je často důležitější než jejich pouhé množství. Zkreslení v datech se přenáší do modelu; viz Rizika AI: bias a diskriminace.
Předtrénování
Při předtrénování model začíná s náhodnými parametry (váhami) a „nic neví“. Úloha je jednoduchá: na základě předchozích tokenů předpovědět další. Model dostane úsek textu, zkusí uhodnout další token, porovná se skutečností a upraví miliardy parametrů tak, aby příště hádal lépe. Opakuje se to biliony krát. Přitom se naučí:
- gramatiku a styl jazyků,
- fakta a vztahy (statisticky),
- vzorce uvažování a postupy (například jak vypadá řešení úlohy),
- programovací jazyky.
Výsledkem je základní (base) model, který umí pokračovat v textu, ale nemusí odpovídat jako asistent: může například na otázku pokračovat další otázkou. Předtrénování je nejnáročnější fáze: vyžaduje tisíce až desetitisíce specializovaných čipů (GPU/TPU) po týdny až měsíce a velké množství energie. Podle výzkumů (například práce o „compute-optimal“ trénování) se vyplatí vyvažovat velikost modelu a množství dat; modely se proto nezvětšují jen „do šířky“. Důležité: model nezískává informace, které nebyly v datech ani události po datu uzávěrky dat (knowledge cutoff). Proto chatboti používají vyhledávání a nástroje; viz AI vyhledávače vs. Google.
Znalosti pocházejí z tréninku k určitému datu. Aktuální informace do odpovědi vnáší až vyhledávání, nástroje či vložené dokumenty. Proto může model neznat nejnovější události, pokud nemá přístup k aktuálním zdrojům.
Instrukční ladění (SFT)
Aby se z „doplňovače textu“ stal asistent, model se dotrénuje na kurátorovaném souboru: dvojicích zadání → vzorová odpověď, které napsali nebo schválili lidé (někdy i jiné modely). Zde se učí:
- následovat pokyny („shrň“, „přelož“, „napiš e-mail“),
- formát odpovědí (odrážky, kód, tabulky),
- tón a styl (zdvořilý, stručný),
- odmítat nevhodné požadavky (počátek bezpečnostního chování),
- používat nástroje (vyhledávání, kalkulačka, kód).
Kvalita a rozmanitost těchto příkladů výrazně ovlivňuje výsledek: i malý, ale dobře zvolený datový soubor dokáže chování modelu výrazně změnit.
Lidská zpětná vazba (RLHF) a příbuzné metody
Instrukčně naladěný model stále může psát nepřesně, rozvláčně či nevhodně. RLHF (učení posilováním z lidské zpětné vazby) to vylepšuje:
- Model vygeneruje několik odpovědí na stejné zadání.
- Lidští hodnotitelé je seřadí od nejlepší po nejhorší (podle užitečnosti, správnosti, bezpečnosti).
- Z těchto pořadí se natrénuje model odměny (reward model), který předpovídá, co lidé preferují.
- Samotný jazykový model se pak upravuje (typicky algoritmem posilovaného učení), aby maximalizoval odměnu, přičemž omezení zabraňuje příliš velké odchylce od původního chování.
Podle publikace OpenAI o modelech, které následují pokyny s lidskou zpětnou vazbou, takto naladěné menší modely mohly být hodnotiteli preferovány před mnohem většími neladěnými. Existují i alternativy a doplňky: DPO (přímá optimalizace preferencí), zpětná vazba od AI (model hodnotí jiný model podle pravidel či „ústavy“), učení z ověřitelných odměn (například u matematiky a kódu, kde lze správnost zkontrolovat) a červené týmy (testování zneužití). Tyto techniky zlepšují užitečnost a bezpečnost, ale nevytvářejí pravdivost: model se může naučit zdvořile znějící, ale nepravdivé odpovědi; viz Proč AI halucinuje.
Testování, bezpečnost a nasazení
Před uvedením model prochází:
- Benchmarky a testy schopností (matematika, kód, jazyk); viz Jak hodnotit AI modely.
- Bezpečnostní evaluace: odolnost proti zneužití, škodlivé rady, zkreslení, soukromí, jailbreaky; viz Jailbreak AI modelů.
- Červené týmy (úmyslné pokusy o prolomení).
- Testy v reálném provozu (postupné zavádění, sběr zpětné vazby).
- Doplňkové ochrany: filtry vstupu a výstupu, systémové pokyny, omezení nástrojů.
Po nasazení se modely průběžně vylepšují (nové verze, opravy chování). Regulace (například evropské nařízení o AI) klade na některé modely povinnosti týkající se transparentnosti a bezpečnosti; viz EU AI Act.
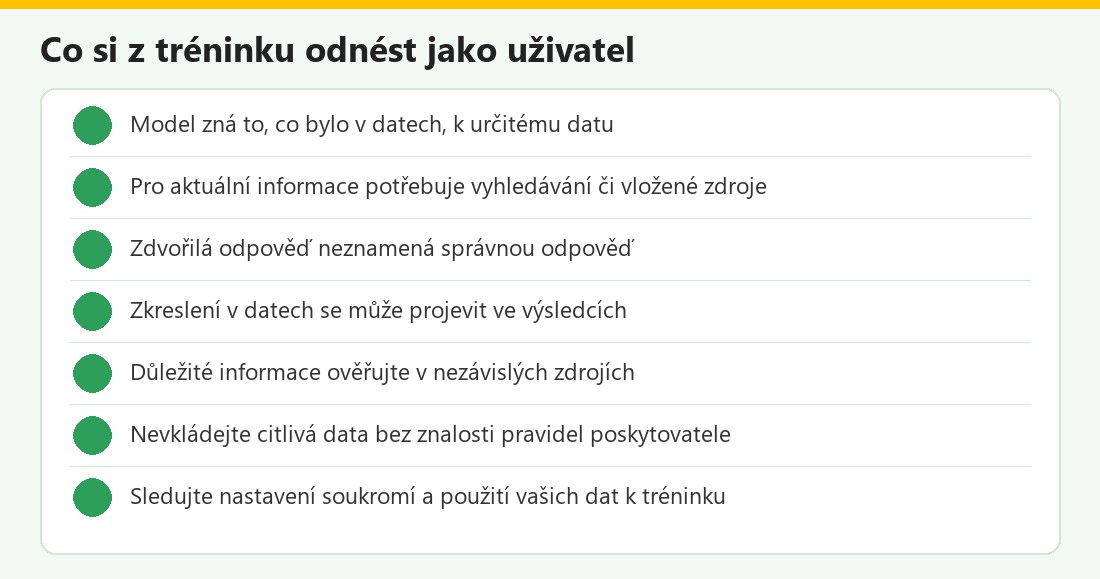 Kontrolní seznam – vlastní infografika
Náklady a omezení
- Výpočetní výkon: předtrénování velkých modelů je extrémně nákladné (hardware, energie, personál); malé organizace si jej obvykle nemohou dovolit, proto využívají hotové modely a dolaďování menších.
- Energie a uhlíková stopa: trénink i provoz mají nezanedbatelnou spotřebu.
- Lidská práce: hodnotitelé a anotátoři jsou nezbytní; jejich pracovní podmínky jsou předmětem diskusí.
- Kvalita dat: nedostatek kvalitních textů v menších jazycích (včetně češtiny) omezuje výkon.
- Zastarávání: model je „zmrazen“ k datu uzávěrky; aktualizace vyžadují další trénink či nástroje.
- Vysvětlitelnost: lze změřit, co model dělá, ale ne vždy dobře vysvětlit proč.
- Zkreslení a škodlivý obsah v datech.
- Bezpečnost trénovacích dat: útoky otravou dat (poisoning) mohou model ovlivnit.
Autorská práva a soukromí dat
Využití textů a obrázků z internetu k tréninku vyvolává právní a etické otázky: smí se na chráněných dílech trénovat? Mají autoři dostat odměnu či právo odmítnout? Pravidla se liší podle země a vyvíjejí se (soudní spory, regulace, licenční dohody). V Evropě platí pravidla o těžbě textů a dat s možností vyhrazení práv; viz Etika AI a autorská práva a AI a autorský zákon v ČR. Soukromí: model může obsahovat osobní údaje z dat či si zapamatovat části; poskytovatelé řeší filtraci a žádosti o výmaz. Vaše konverzace mohou být (podle nastavení) použity k dalšímu zlepšování služby; kontrolujte nastavení; viz AI chatboti a soukromí dat a AI a ochrana osobních údajů (GDPR).
Dolaďování vlastních modelů a firem
Firmy a vývojáři obvykle netrénují modely od nuly. Možnosti:
- Prompting: vhodné zadání a příklady.
- RAG (vyhledávání ve vlastních dokumentech): model odpovídá s využitím vložených zdrojů; viz RAG a fine-tuning.
- Fine-tuning: dolaďování existujícího modelu na vlastních datech (styl, formát, doména).
- Otevřené modely: spuštění a úprava vlastní kopie; viz Open-source AI modely.
Důležité je chránit data používaná k dolaďování (osobní údaje, obchodní tajemství), mít právní základ a ověřovat výsledky.
Časté otázky v praxi
Odkud model ví, co ví?: z dat použitých k tréninku. Proč neví nejnovější události?: kvůli uzávěrce dat; potřebuje vyhledávání. Učí se můj chatbot z mých konverzací?: záleží na službě a nastavení; zkontrolujte soukromí. Proč je odpověď zdvořilá, ale špatná?: tréninková preference za příjemný styl nezaručuje pravdivost. Může si model data „pamatovat“?: částečně, proto jsou důležité zásady a filtry.
Trénink AI v kostce
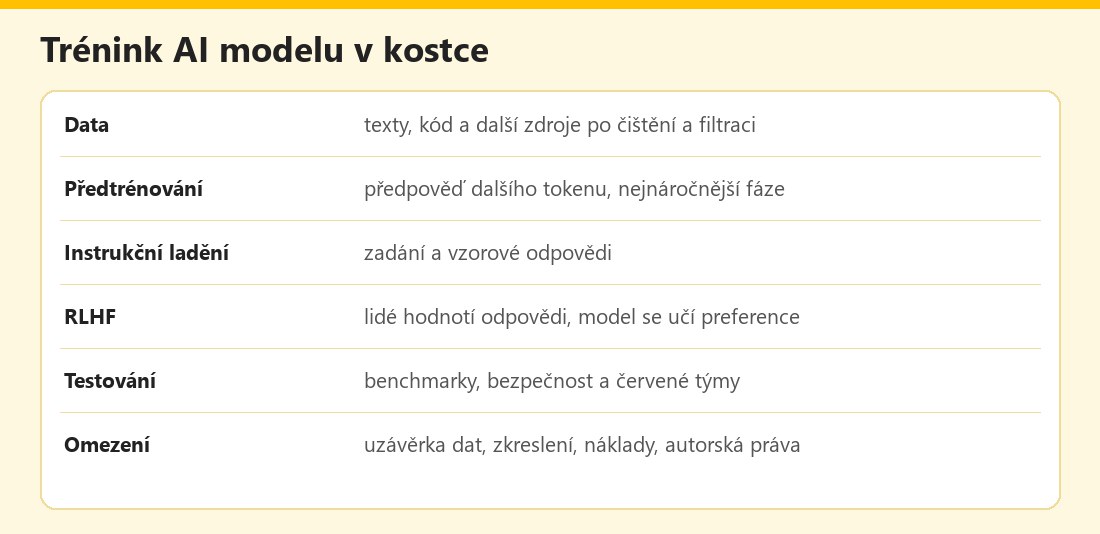 Základní údaje – vlastní infografika
Výhody a nevýhody
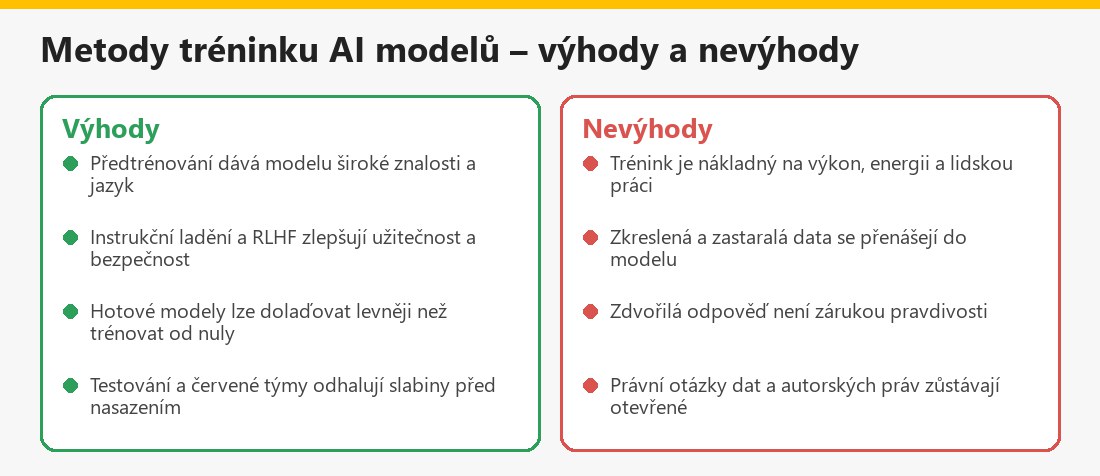 Souhrn pro čtenáře – vlastní infografika
Související články
Další články najdete v kategorii Základy a principy AI: RAG a fine-tuning, Generativní AI vs. klasická AI, Historie umělé inteligence a Slovník pojmů umělé inteligence.
Shrnutí
Velký jazykový model vzniká předtrénováním na obrovském korpusu (předpověď dalšího tokenu), poté instrukčním laděním a dolaďováním podle lidských preferencí (RLHF), následuje testování a nasazení. Model zná jen data k datu uzávěrky, může být zkreslený a zdvořilost neznamená pravdivost. Více najdete v přehledu A Survey of Large Language Models.
Často kladené otázky k tréninku AI modelů
Jak se trénuje jazykový model?
Předtrénováním na předpovídání dalšího tokenu, instrukčním laděním na zadáních a odpovědích a dolaďováním podle lidské zpětné vazby.
Co je předtrénování?
Fáze, kdy se model na obrovském korpusu učí předpovídat další token a získává jazyk a znalosti.
Co je RLHF?
Učení posilováním z lidské zpětné vazby: lidé hodnotí odpovědi, z toho vznikne model preferencí a model se podle něj upravuje.
Proč neví model nejnovější události?
Zná data jen do uzávěrky tréninku; aktuální informace dodá až vyhledávání či vložené zdroje.
Z jakých dat se učí?
Z webu, knih, článků, kódu a licencovaných či syntetických dat po čištění a filtraci.
Proč je trénink drahý?
Vyžaduje tisíce výkonných čipů po týdny či měsíce, energii a lidskou práci hodnotitelů.
Učí se model z mých konverzací?
Záleží na službě a nastavení soukromí; zkontrolujte, zda lze použití dat k tréninku vypnout.
Můžu model dolaďovat sám?
Ano, u dostupných modelů lze dolaďovat či využít RAG; je třeba chránit data a ověřovat výsledky.
