
Jak hodnotit AI modely – benchmarky, žebříčky a vlastní testy: co čísla skutečně říkají a kde klamou
Nové modely AI dostávají tisková sdělení typu „překonal lidské experty“, „nejlepší na světě“ či „87 % na testu X“. Čísla vypadají přesvědčivě, ale pro běžného uživatele či firmu je těžké poznat, co vlastně znamenají a zda model skutečně splní jejich úlohu. Benchmarky (standardizované testy) jsou užitečné, protože umožňují srovnat modely na stejných úlohách, ale mají vážná omezení: modely se na ně mohou nechtěně (či záměrně) „naučit“, testy rychle zastarávají (modely se blíží stropu), neměří spolehlivost, bezpečnost ani pohodlí a výsledky u různých autorů se liší podle nastavení. Dobrá zpráva: i běžný uživatel může modely srovnat způsobem, který je nejrelevantnější: na vlastních úlohách.
V tomto článku vysvětlujeme, co jsou benchmarky a jak je číst, jaké typy testů existují (znalosti, uvažování, kód, preference lidí), proč mohou klamat (kontaminace, přeučení, marketing, nastavení), jak fungují žebříčky založené na hlasování uživatelů, jak si vytvořit vlastní test, jaká další kritéria zvážit (cena, rychlost, bezpečnost, soukromí) a jak se rozhodnout. Čerpáme z publikací Measuring Massive Multitask Language Understanding (MMLU), GPQA, SWE-bench, Chatbot Arena, Holistic Evaluation of Language Models (HELM), z projektů SWE-bench, Stanford HELM a Epoch AI: Benchmarks (anglicky). Konkrétní hodnoty a pořadí modelů se mění téměř týdně, proto je zde neuvádíme; hledejte vždy aktuální stav.
Další články najdete v kategorii Základy a principy AI, například Jak se trénuje AI model, AGI a superinteligence a Proč AI halucinuje.
Aktualizováno: listopad 2026.
Co je benchmark
Benchmark je standardizovaná sada úloh s předem známým způsobem hodnocení, na které se modely testují, aby bylo možné je porovnat. Může jít o otázky s výběrem odpovědi, úlohy z matematiky, programování, porozumění textu či konverzaci. Výsledek je skóre (procento správných odpovědí, úspěšně vyřešených úloh, pořadí). Slouží k:
- sledování pokroku v čase,
- srovnání modelů a verzí,
- odhalování slabin (v jakých oblastech selhávají),
- rozhodování firem a vývojářů o výběru modelu.
Nenahrazují ale hodnocení pro konkrétní použití.
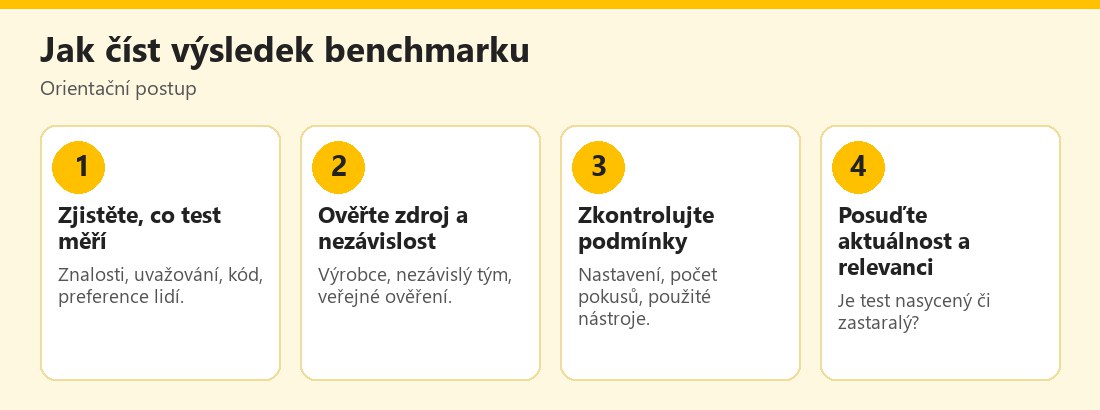 Orientační postup čtení výsledku benchmarku – vlastní infografika
Typy benchmarků
- Znalosti a obecné schopnosti: například MMLU (Massive Multitask Language Understanding) testuje otázky z mnoha oborů (od práva po matematiku) formou výběru odpovědi.
- Odborné a náročné otázky: GPQA obsahuje otázky na úrovni postgraduálního studia z přírodních věd, navržené tak, aby je nešlo snadno dohledat vyhledávačem („Google-proof“).
- Matematika a logika: soustavy slovních úloh, olympiádní příklady.
- Programování: úlohy generování kódu; SWE-bench zkoumá, zda model dokáže opravit skutečné chyby z veřejných repozitářů (reálné GitHub issues); viz projekt SWE-bench.
- Agentní úlohy: dlouhé úlohy s nástroji (prohlížeč, terminál, e-mail), které testují plánování a autonomii; viz AI agenti.
- Konverzace a preference lidí: Chatbot Arena (nyní provozovaná jako veřejný žebříček) nechává uživatele porovnávat anonymní odpovědi dvou modelů a hlasovat, která je lepší; z hlasování se počítá pořadí (podobné šachovému hodnocení).
- Holistické hodnocení: projekt HELM (Stanford) hodnotí modely v mnoha scénářích a podle více kritérií (přesnost, robustnost, zkreslení, toxicita, efektivita), nejen jedním číslem.
- Multimodální testy (obraz, zvuk, video); viz Multimodální AI.
- Bezpečnostní testy: odolnost proti zneužití, jailbreak, zkreslení; viz Jailbreak AI modelů.
- Jazykové testy: výkon v češtině a dalších jazycích bývá nižší než v angličtině a zřídka se měří.
Agregátory a nezávislé organizace (například Epoch AI) shromažďují výsledky více testů a porovnávají je.
Proč mohou čísla klamat
- Kontaminace dat: pokud se otázky z testu dostaly do trénovacích dat modelu (testy jsou veřejné), model je může „znát“, a skóre pak nevypovídá o schopnosti zobecnit. Proto vznikají nové, skryté či často obměňované testy.
- Přeučení na test (benchmark gaming): vývojáři mohou model záměrně ladit na známé benchmarky; výsledek se zlepšuje víc než skutečná užitečnost (Goodhartův zákon: když se z míry stane cíl, přestane být dobrou mírou).
- Nasycení: u starších testů se špičkové modely blíží maximu, takže rozdíly jsou malé a nepodstatné; test přestává rozlišovat.
- Nastavení hodnocení: výsledek závisí na zadání (promptu), počtu pokusů, použití nástrojů, teplotě a „výběru nejlepší z mnoha odpovědí“; různé zprávy proto nejsou přímo srovnatelné.
- Vlastní testy výrobce: firma si vybere testy, kde vychází dobře, a uvede jen jejich výsledky (výběrové vykazování).
- Chyby v testech: některé benchmarky obsahují chybné otázky či odpovědi, což snižuje strop a zkresluje výsledky.
- Úzký rozsah: test z jedné oblasti nepředpovídá výkon v jiné; „dobrý v matematice“ neznamená „dobrý v psaní e-mailů“.
- Neměří spolehlivost: model může správně odpovědět v 90 % případů, ale zbylých 10 % vyvolá chyby s jistotou; to je pro praxi důležité.
- Neměří použitelnost: rychlost, ovládání, integrace, styl odpovědí a ochota přiznat nejistotu.
- Zkreslení hlasování: v žebříčcích podle preferencí uživatelé nejčastěji vybírají delší, vlídnější či lépe formátované odpovědi, což není totéž co přesnější; vliv stylu se vývojáři snaží omezovat, ale přetrvává.
- Jazyk: většina benchmarků je anglicky; výsledky pro češtinu se mohou lišit.
- Marketing: tisková sdělení využívají zaokrouhlení, výběr metrik a superlativy.
Který model je nejlepší, závisí na úloze, jazyce, ceně, rychlosti a pravidlech pro data. Žebříček vám řekne, kdo vede v určitém testu, ne který model je nejlepší pro vaši práci. Nejspolehlivější je vyzkoušet model na vlastních reálných úlohách.
Jak si vytvořit vlastní test
Nejužitečnější hodnocení je na vašich úlohách. Jednoduchý postup:
- Vyberte 10–30 reálných úloh, které budete s AI řešit: například shrnutí dokumentu, odpověď na dotaz zákazníka, přepis e-mailu, úprava textu, dotaz na kód, extrakce údajů.
- Zvolte kritéria: správnost, úplnost, styl, jazyk (čeština), ochota přiznat nejistotu, časová náročnost, počet nutných oprav.
- Připravte „zlatou odpověď“ (nebo hodnoticí kritéria) pro ověření správnosti.
- Zadejte stejná zadání více modelům (a opakujte, protože výstupy se liší), pokud možno naslepo (bez vědomí, který model odpovídá).
- Ohodnoťte výsledky (například škálou 1–5 a počet nutných oprav) a zaznamenejte případy selhání.
- Zahrňte „zrádné“ úlohy: dotaz, na který model nemá znát odpověď; kontrolu, zda si nevymýšlí; viz Proč AI halucinuje.
- Testujte i bezpečnost a soukromí: co se stane s daty, zda lze vypnout trénování; viz AI chatboti a soukromí dat.
- Opakujte při nové verzi: modely se mění; vlastní testy slouží jako „regresní sada“.
- Zapojte více lidí: hodnocení jedním člověkem je subjektivní.
- Zvažte cenu a rychlost: srovnejte kvalitu v poměru k nákladům.
U firem lze test automatizovat (sada otázek a kontrola odpovědí) a hodnocení doplnit „modelem jako soudcem“, ale ten je třeba sám kontrolovat.
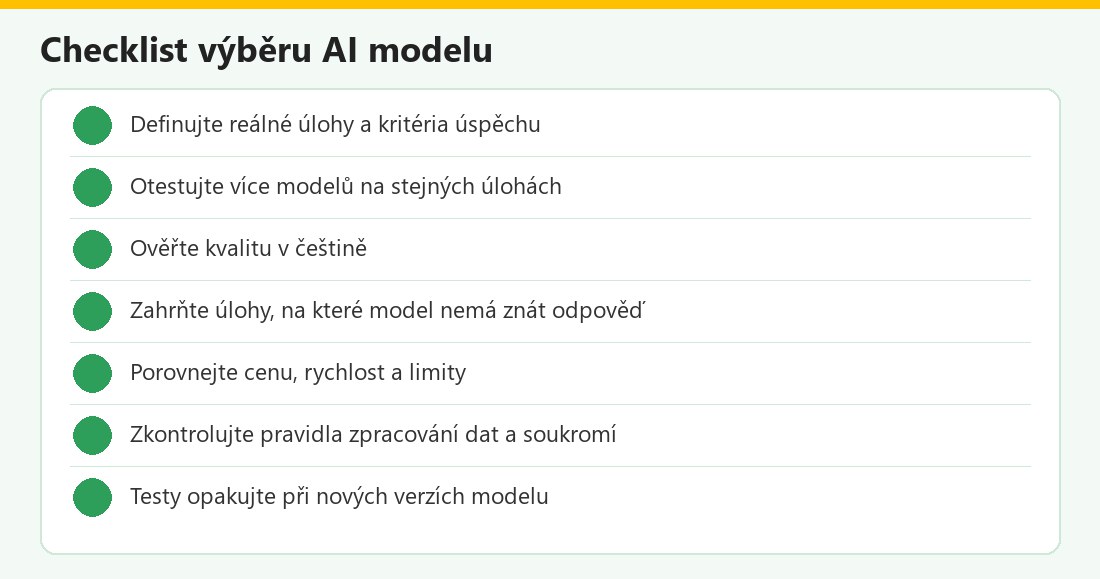 Kontrolní seznam – vlastní infografika
Další kritéria kromě skóre
- Spolehlivost a halucinace: jak často model vymýšlí fakta; jak ochotně přizná nejistotu.
- Čeština a další jazyky: kvalita jazyka, odborná terminologie, tokenizace a náklady; viz Tokeny a kontextové okno.
- Cena a limity: předplatné, API, kvóty; viz Alternativy k ChatGPT.
- Rychlost a latence.
- Délka kontextu a práce s dokumenty.
- Funkce: vyhledávání, nástroje, kód, obrázky, hlas, paměť.
- Bezpečnost a ochrana dat: nastavení soukromí, použití dat k trénování, umístění zpracování, certifikace; viz Únik dat do AI chatbotů.
- Možnost lokálního provozu pro citlivá data; viz Open-source AI modely.
- Dostupnost a stabilita služby, podpora, smluvní podmínky.
- Soulad s regulací; viz EU AI Act.
- Etika a transparentnost poskytovatele (dokumentace, zprávy o bezpečnosti).
Jak číst zprávy o „překonání lidí“
Titulky „AI překonala lidské experty“ obvykle znamenají, že model dosáhl vyššího skóre na konkrétním testu. Zvažte:
- Který test a který lidský výkon? (průměrný student, odborník, nejlepší na světě?)
- Za jakých podmínek (nástroje, čas, počet pokusů)?
- Byl test nezávisle ověřen a není kontaminován?
- Přenáší se výsledek do praxe? Řešení úloh z testu není totéž co práce lékaře či právníka.
- Kdo zprávu zveřejnil a jaký má zájem?
Příkladem je rozdíl mezi řešením výběrových otázek a plněním dlouhé reálné úlohy (například oprava chyby v rozsáhlém softwaru, kde se modely zlepšují, ale spolehlivost je omezená; viz SWE-bench). Pro širší kontext srovnávejte s AGI a superinteligence.
Firmy a organizace
Firmy by měly vytvořit interní sadu testů odpovídající jejich procesům, monitorovat kvalitu v provozu (vzorkování odpovědí, zpětná vazba uživatelů), testovat po každé změně modelu, měřit chyby, náklady a rizika, stanovit hranice autonomie a dokumentovat hodnocení (zejména u vysoce rizikových systémů podle regulace). U rozhodování o nákupu využívejte pilotní provoz, ne jen žebříčky; viz AI v práci: jak efektivně a bezpečně využívat ChatGPT a Firemní politika používání AI.
Časté otázky v praxi
Je model s nejvyšším skóre nejlepší?: jen v daném testu; pro vás rozhoduje vaše úloha. Je Chatbot Arena spolehlivá?: dobře odráží preference uživatelů, ale ty nemusí odpovídat správnosti. Co je kontaminace?: případ, kdy testové otázky unikly do trénovacích dat. Jak otestovat model v češtině?: sadou vlastních úloh. Měnit modely často?: sledujte novinky, ale měňte podle vlastních testů.
Hodnocení AI v kostce
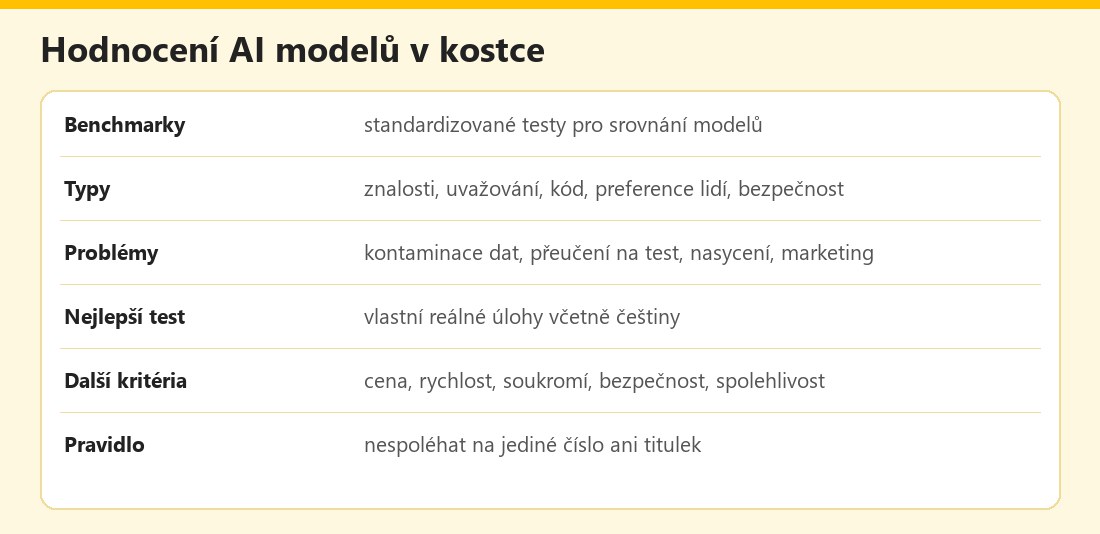 Základní údaje – vlastní infografika
Výhody a nevýhody
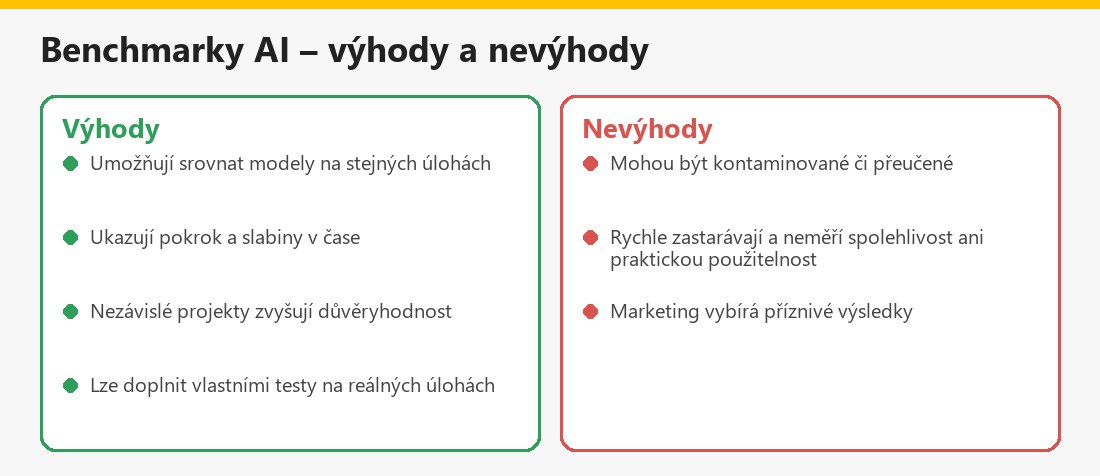 Souhrn pro uživatele – vlastní infografika
Související články
Další články najdete v kategorii Základy a principy AI: Slovník pojmů umělé inteligence, Multimodální AI, RAG a fine-tuning a Historie umělé inteligence.
Shrnutí
Benchmarky umožňují srovnat modely, ale čísla mohou klamat: kontaminace dat, přeučení na test, nasycení, rozdíly v nastavení a marketing. Žebříčky podle hlasování zachycují preference, ne vždy správnost. Nejlepší je vytvořit vlastní test na reálných úlohách včetně češtiny a zohlednit cenu, rychlost, soukromí a spolehlivost. Více najdete v práci HELM a na stránkách Epoch AI.
Často kladené otázky k hodnocení AI modelů
Co je benchmark?
Standardizovaná sada úloh s předem daným hodnocením, na které se modely testují pro porovnání.
Co měří MMLU?
Znalosti a porozumění v mnoha oborech formou otázek s výběrem odpovědi.
Co je Chatbot Arena?
Žebříček z hlasování uživatelů, kteří porovnávají anonymní odpovědi dvou modelů.
Proč mohou čísla klamat?
Kvůli kontaminaci dat, přeučení na test, nasycení testů, odlišným nastavením a výběrovému zveřejňování.
Je model s nejvyšším skóre nejlepší?
Jen v daném testu; pro vás rozhoduje výkon na vašich úlohách, cena a pravidla pro data.
Jak si vytvořit vlastní test?
Vybrat reálné úlohy, určit kritéria, zadat je více modelům a ohodnotit výsledky, nejlépe naslepo.
Měří benchmarky češtinu?
Většinou málo; čeština bývá slabší a je třeba ji otestovat zvlášť.
Na co ještě myslet?
Na spolehlivost, soukromí dat, cenu, rychlost a funkce modelu.
