
LLM jako soudce – jak MT-Bench a Chatbot Arena hodnotí chatboty a jaká jsou omezení
Který chatbot je „nejlepší“? Odpověď se objevuje v žebříčcích a srovnáních, ale jak se taková čísla vlastně získávají? Klasické testy s jedinou správnou odpovědí (kvíz, matematika) nezachytí, jak dobře asistent vede rozhovor, vysvětluje a řídí se pokyny. Lidské hodnocení je drahé a pomalé. Proto se prosadil přístup „LLM jako soudce“ (LLM-as-a-judge): jeden silný jazykový model posuzuje odpovědi jiných modelů. Tento článek vysvětluje, jak to funguje, jaké výsledky popisuje studie o MT-Benchi a Chatbot Arena a jaká omezení je třeba znát, když čtete žebříčky.
Informace vycházejí z abstraktu studie Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena (arXiv:2306.05685; Zheng a kol., 13 autorů; první verze 9. 6. 2023, čtvrtá z 24. 12. 2023; NeurIPS 2023, Datasets and Benchmarks Track), z rámce NIST AI RMF a z doporučení Anthropic k definici kritérií úspěchu (stav k 14. 11. 2026). Žebříčky a modely se rychle mění; konkrétní pořadí zde neuvádíme. Nejde o technický návod.
Související články: Jak hodnotit AI modely – benchmarky, Model cards a ChatGPT vs. Gemini vs. Claude – srovnání.
Aktualizováno: listopad 2026.
Proč klasické testy nestačí
Studie vychází z problému: standardní benchmarky nezachycují lidské preference pro chatovací asistenty, a získávání lidského hodnocení je drahé. Asistent se hodnotí zejména podle toho, zda je odpověď užitečná, srozumitelná, přiměřeně podrobná a odpovídá na zadání. To lze těžko změřit jedním číslem. Autoři proto použili silné jazykové modely jako soudce, kteří hodnotí odpovědi na otevřené otázky.
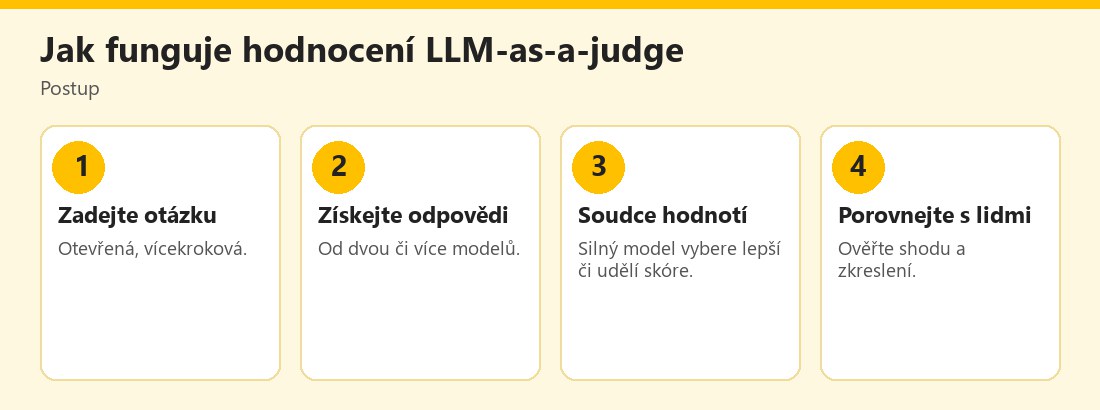 Postup hodnocení pomocí LLM jako soudce – vlastní infografika
Dva nástroje: MT-Bench a Chatbot Arena
- MT-Bench je sada vícekolových otázek (multi-turn), které prověřují, jak model zvládá navazující rozhovor a pokyny.
- Chatbot Arena je crowdsourcingová „aréna“, kde lidé porovnávají odpovědi dvou anonymních modelů a vybírají lepší.
Studie srovnává, jak se hodnocení silných LLM shoduje s lidmi.
Hlavní výsledek: přes 80 % shoda
Autoři uvádějí, že silní soudci jako GPT-4 se shodují s kontrolovanými i crowdsourcovanými lidskými preferencemi ve více než 80 % případů, tedy zhruba stejně často, jako se shodují lidé mezi sebou. Závěr zní: LLM jako soudce je škálovatelný a vysvětlitelný způsob, jak aproximovat lidské preference. Soudce navíc může zdůvodnit, proč vybral určitou odpověď, což usnadňuje kontrolu.
Omezení a zkreslení soudců
Studie zkoumá několik problémů:
- Poziční zkreslení (position bias). Soudce může upřednostňovat odpověď, která je v dvojici uvedena jako první (či druhá), bez ohledu na kvalitu.
- Zkreslení délkou (verbosity bias). Delší, rozvláčnější odpovědi se mohou jevit lepší.
- Sebe-zvýhodňování (self-enhancement bias). Model může preferovat odpovědi vlastního typu či stylu.
- Omezené schopnosti uvažování. Soudce může chybovat při hodnocení matematických či logických úloh.
Autoři navrhují řešení, jak některé z těchto problémů zmírnit. V praxi se pomáhá například střídáním pořadí odpovědí a pečlivým zadáním pro soudce (to už je obecná praxe, nikoli závěr z abstraktu). Pro čtenáře žebříčků z toho plyne důležité poučení: číslo je užitečný signál, ne absolutní pravda.
Jak číst žebříčky a hodnocení
- Zjistěte metodiku. Kdo hodnotil (lidé, model), jaké otázky, kolik hodnocení?
- Pozor na délku odpovědí. Pokud výsledky silně závisí na délce, může jít o zkreslení.
- Sledujte spolehlivost. Malé rozdíly v pořadí nemusí být významné.
- Rozlišujte úlohy. Model dobrý v konverzaci nemusí být nejlepší v programování, matematice či češtině.
- Ověřte jazyk. Žebříčky často vycházejí hlavně z angličtiny; viz AI chatboti a čeština.
- Pozor na zájmy. Poskytovatelé modelů mají motivaci ukazovat výsledky, kde si vedou dobře.
- Otestujte na vlastních úlohách. Nejlepší hodnocení je to, které odpovídá vašemu použití.
Jak využít myšlenku pro vlastní hodnocení
Pokud ve firmě nebo škole vybíráte AI nástroj, můžete postupovat podobně, ale zodpovědněji:
- Definujte kritéria úspěchu. Dokumentace Anthropic doporučuje před zlepšováním zadání mít jasnou definici kritérií úspěchu, způsoby jejich empirického testování a první verzi zadání.
- Sestavte vlastní sadu otázek z reálného provozu (20 až 50 příkladů stačí na orientaci).
- Nechte hodnotit lidmi (nejlépe dvěma odborníky) a případně doplňte hodnocením pomocí modelu pro rychlý pohled.
- Střídejte pořadí odpovědí, abyste omezili poziční zkreslení.
- Zaznamenejte případy selhání, ne jen průměr.
- Opakujte test při změně modelu či zadání.
NIST AI RMF zdůrazňuje, že měření přesnosti má vycházet z realistických testovacích sad reprezentativních pro očekávané použití a mít zdokumentovanou metodiku; viz NIST AI RMF.
Kdy je hodnocení modelem rozumné a kdy ne
Rozumné: rychlé porovnání variant zadání, předběžné třídění mnoha odpovědí, kontrola formálních vlastností (zda odpověď dodržela formát), monitoring kvality v provozu (jako doplněk). Nevhodné jako jediný nástroj: rozhodnutí s dopadem na lidi (nábor, zdraví, právo), hodnocení faktické pravdivosti bez zdrojů, posuzování citlivých či kulturně specifických témat, situace, kdy soudce a hodnocený model pocházejí od téhož poskytovatele.
Co z toho plyne pro uživatele
Žebříčky chatbotů jsou užitečné jako orientace, ale nevybírejte nástroj jen podle pořadí. Zkuste víc nástrojů na vlastních úlohách, sledujte cenu, soukromí a podmínky; viz ChatGPT vs. Gemini vs. Claude – srovnání a AI chatboti a soukromí dat. Pokud potřebujete ověřená fakta, spoléhejte na primární zdroje, ne na „hodnocení nejlepšího modelu“.
Hodnocení a bezpečnost
Při hodnocení modelů se nesleduje jen užitečnost, ale také bezpečnost a spolehlivost: zda model odmítá škodlivé požadavky, neprozrazuje citlivé údaje, nenaletí na prompt injection a nepodléhá jailbreaku. Tyto vlastnosti běžné žebříčky konverzační kvality nezachycují; viz Prompt injection a Jailbreak AI modelů. Pokud AI nasazujete v prostředí s dopadem na lidi, doplňte hodnocení o testy rizik a lidský dohled podle rámců, jako je NIST AI RMF. Pro orientaci: vysoké skóre v „kvalitě konverzace“ neznamená vysokou bezpečnost.
Pozor na „učení na test“
Jakmile se z veřejného žebříčku stane cíl, může se model (nebo jeho zadání) přizpůsobit právě jemu. Pokud se otázky z testů objevily v trénovacích datech, jsou výsledky nadsazené. Je to podobné, jako když se žák učí nazpaměť otázky z minulých testů. Proto jsou důležité neveřejné testovací sady a pravidelná obměna otázek. Čtenář může ověřit, zda poskytovatel uvádí metodiku a zda jsou k dispozici nezávislé testy. Souvislosti s dokumentací modelů viz Model cards.
Další zdroje
Vlastní hodnocení se vyplatí propojit s dokumentací poskytovatelů, například pokyny OpenAI ke kvalitě a nákladům reasoning modelů, a se studiem principů fungování jazykových modelů v Google – Introduction to LLMs. Obecně platí: pokud nelze hodnocení zopakovat a vysvětlit, berte je jako marketing, ne jako důkaz.
Praktický příklad (smyšlený)
Zákaznická linka firmy porovnává dva chatboty. Z vlastních e-mailů vybere 40 dotazů, obě odpovědi uloží v náhodném pořadí a nechá je ohodnotit dvěma kolegy. Pro rychlý pohled použije i hodnocení silným modelem, ale všimne si, že preferuje delší odpovědi. Rozhodne se podle lidského hodnocení a přidá pravidlo, že odpověď má být stručná. Příklad je smyšlený.
Silné modely jako soudci se podle studie shodují s lidmi z více než 80 %, ale mají poziční, délkové a sebe-zvýhodňující zkreslení. Výsledky berte jako orientaci a ověřte je na vlastních úlohách.
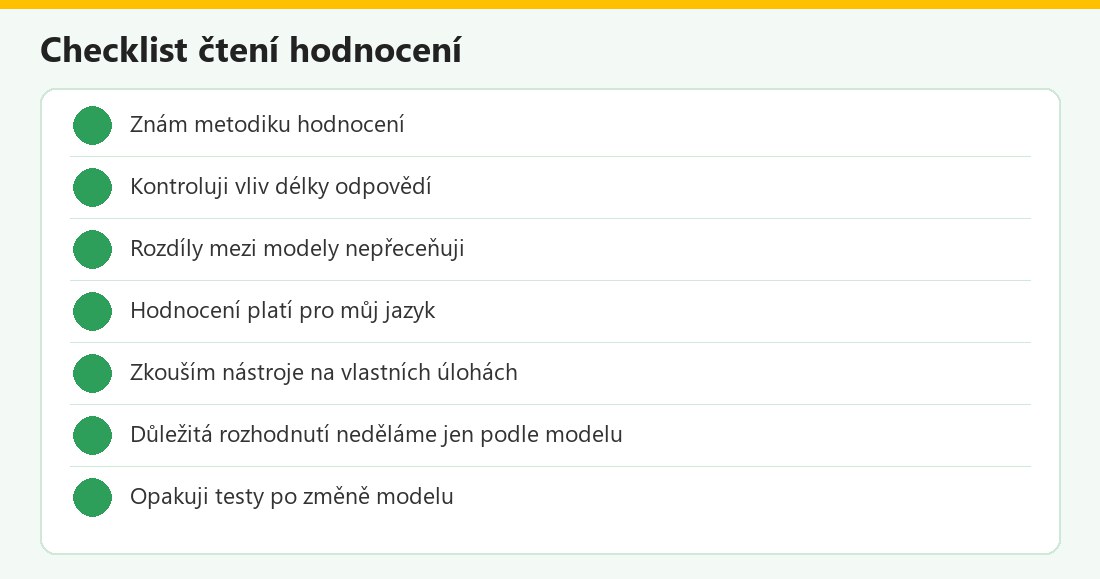 Kontrolní seznam – vlastní infografika
LLM-as-a-judge v kostce
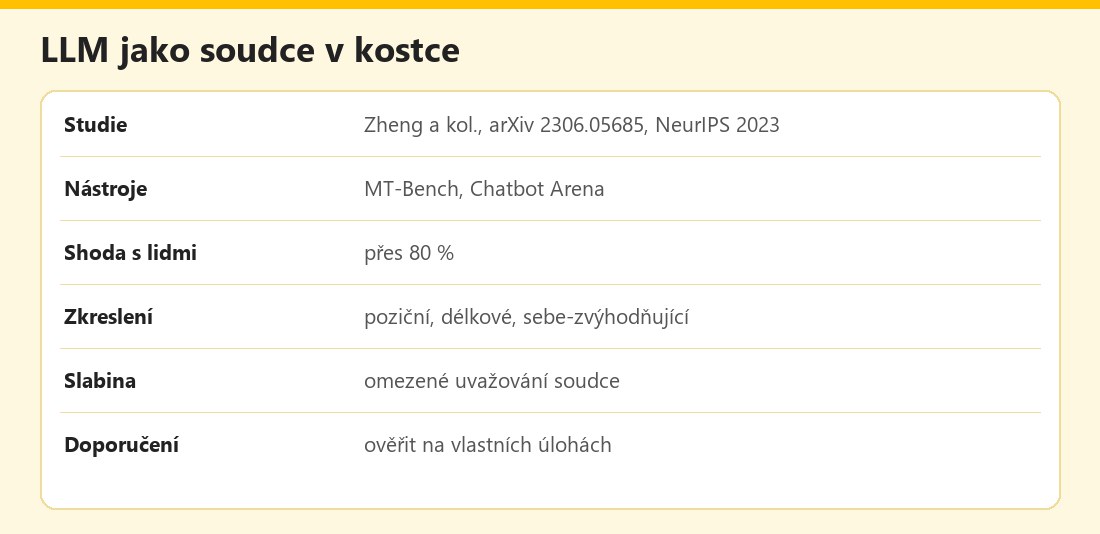 Základní údaje – vlastní infografika
Výhody a nevýhody
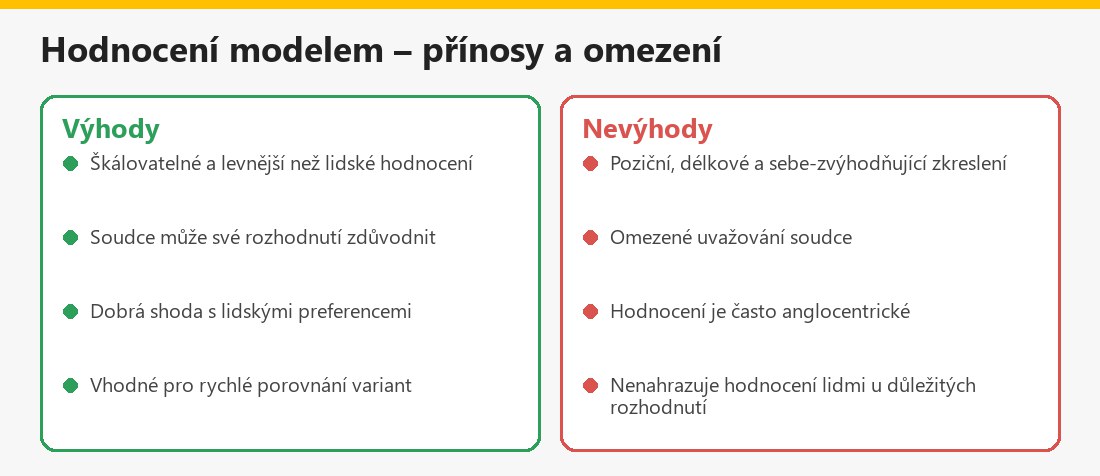 Souhrn – vlastní infografika
Související články
V kategorii Základy a principy AI najdete také Multimodální AI a Halucinace.
Shrnutí
LLM jako soudce využívá silné modely k hodnocení odpovědí chatbotů; studie o MT-Benchi a Chatbot Arena uvádí shodu s lidmi přes 80 %, zároveň ale popisuje poziční, délkové a sebe-zvýhodňující zkreslení a omezené uvažování. Žebříčky berte jako orientaci, ověřte metodiku a testujte na vlastních úlohách. Nejde o technický návod.
Často kladené otázky k hodnocení chatbotů
Co je LLM jako soudce?
Použití silného jazykového modelu k hodnocení odpovědí jiných modelů.
Co je MT-Bench?
Sada vícekolových otázek pro hodnocení konverzačních schopností modelů.
Co je Chatbot Arena?
Crowdsourcingová platforma, kde lidé porovnávají odpovědi anonymních modelů.
Jak moc se soudce shoduje s lidmi?
Podle studie silní soudci jako GPT-4 dosahují shody přes 80 %, zhruba jako lidé mezi sebou.
Jaká jsou zkreslení?
Poziční, délkové a sebe-zvýhodňující; navíc omezené uvažování soudce.
Mám věřit žebříčkům?
Berte je jako orientaci; ověřte metodiku a testujte na vlastních úlohách.
Může soudcem hodnotit model od téhož poskytovatele?
Hrozí sebe-zvýhodňování; je vhodné doplnit lidské hodnocení.
Je to technický návod?
Ne, jde o obecné shrnutí.
