
Embeddingy a vektorové vyhledávání – jak AI měří podobnost textů a jaká jsou omezení
Když zadáte do moderního vyhledávače nebo AI asistenta dotaz „jak ošetřit spáleninu“, často najde i dokument, který slovo „spálenina“ vůbec neobsahuje, ale mluví o „popálení kůže“. Dokáže to díky embeddingům: číselným „otiskům“ významu textu. Jde o jeden z nejdůležitějších, a přitom nejméně viditelných stavebních kamenů současné umělé inteligence. Tento článek vysvětluje co embedding je, jak se pomocí něj měří podobnost, k čemu se používá (včetně spojení s technikou RAG) a jaká jsou omezení a rizika.
Informace vycházejí z dokumentace OpenAI – Embeddings, z kurzu Google Machine Learning Crash Course – Embeddings a z úvodu Google – Introduction to LLMs (stav k 14. 11. 2026). Konkrétní modely a parametry se u poskytovatelů mění. Nejde o technický návod.
Související články: RAG a fine-tuning, Tokeny a kontextové okno a Jak funguje umělá inteligence.
Aktualizováno: listopad 2026.
Co je embedding
Podle dokumentace OpenAI je embedding vektor (seznam) desetinných čísel, který reprezentuje textový řetězec. Vzdálenost mezi dvěma vektory měří, jak spolu texty souvisejí: „malé vzdálenosti naznačují vysokou příbuznost, velké nízkou“. Jinými slovy: model převede každý text na „bod v prostoru“ a podobné významy skončí blízko sebe.
Kurz Googlu přibližuje základní myšlenku přes rozdíl mezi kódováním a embeddingem. Při one-hot kódování dostane každá položka datové sady vektor tak dlouhý, jako je počet položek (u 5 000 jídel vektor o 5 000 prvcích, kde je jediná jednička). Takové řídké reprezentace mají problémy: vyžadují mnoho vah v neuronové síti, více trénovacích dat, více výpočtů a paměti a těžko se spouštějí na zařízeních. Embedding je reprezentace řídkých dat v menším počtu rozměrů. Kurz ukazuje motivační příklad aplikace na doporučování jídel, která má poznat, že člověku, kterému chutnají palačinky, se mohou líbit i crêpes.
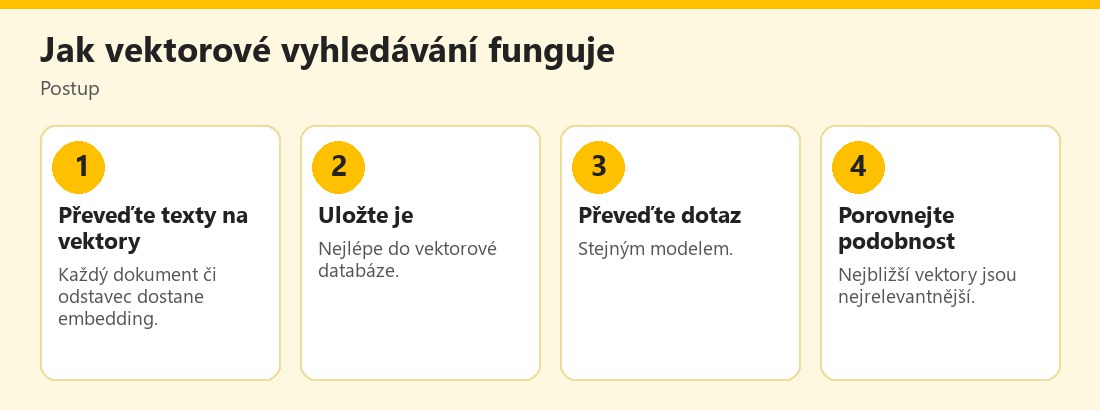 Postup vektorového vyhledávání – vlastní infografika
K čemu se embeddingy používají
Dokumentace OpenAI uvádí tyto případy použití:
- Vyhledávání: výsledky se řadí podle relevance k dotazu.
- Shlukování: texty se seskupují podle podobnosti.
- Doporučování: nabízejí se položky, jejichž text souvisí s tím, co si uživatel prohlíží.
- Detekce anomálií: odlehlé texty, které s ostatními téměř nesouvisejí.
- Klasifikace: text se přiřadí štítku, kterému je nejpodobnější. Funguje i bez označených trénovacích dat (zero-shot), když se text porovná s embeddingy názvů kategorií.
- Dále měření rozmanitosti nebo použití embeddingů jako vstupů do dalších modelů strojového učení.
V praxi jsou embeddingy základem sémantického vyhledávání a techniky RAG (retrieval-augmented generation): dokumenty firmy se rozdělí na části, převedou na vektory a při dotazu se vyberou ty nejpodobnější, které se předají jazykovému modelu jako podklad pro odpověď; viz RAG a fine-tuning.
Jak se měří podobnost
OpenAI doporučuje kosinovou podobnost; podle dokumentace na volbě vzdálenostní funkce obvykle příliš nezáleží. Embeddingy OpenAI jsou normalizovány na délku 1, takže kosinovou podobnost lze spočítat jen skalárním součinem a kosinová podobnost i euklidovská vzdálenost dávají stejné pořadí. Pro rychlé hledání nejbližších sousedů mezi velkým množstvím vektorů dokumentace doporučuje vektorovou databázi.
Rozměry embeddingu
Podle dokumentace mají výchozí modely délku 1536 (text-embedding-3-small) a 3072 (text-embedding-3-large). Parametr `dimensions` umožňuje embedding zkrátit při zachování významu; doporučeno je nastavit ho při vytváření. Pokud vektor zkrátíte ručně, je nutné ho znovu normalizovat. Dokumentace uvádí příklad, že embedding většího modelu zkrácený na 256 rozměrů stále překonává starší nezkrácený model s 1536 rozměry v benchmarku MTEB. Větší embeddingy stojí víc na uložení i výpočet. Zároveň platí, že redukce rozměrů metodami jako SVD či PCA obecně zhoršuje výkon (podle dokumentace i u 10% redukce).
Omezení
- Znalosti modelu: modely třetí generace podle dokumentace neznají události po září 2021; obvykle jde o drobné omezení, ale v některých případech může snížit výkon.
- Maximální vstup: modely mají omezený počet tokenů (8192 u uvedených modelů), proto se dlouhé dokumenty dělí na části; viz Tokeny a kontextové okno.
- Podobné neznamená správné. Embedding najde příbuzný text, ne nutně pravdivý či aktuální.
- Jazyk a doména. Kvalita se liší podle jazyka a oboru; češtinu vždy otestujte na vlastních datech.
- Nejde o záruku soukromí. Nelze automaticky předpokládat, že embeddingy jsou anonymní; chraňte je jako zdrojové texty.
Soukromí a bezpečnost
Pokud do vektorového vyhledávání vkládáte osobní či důvěrné dokumenty, myslete na to, že:
- textové části se často ukládají vedle vektorů a mohou se zobrazit v odpovědích,
- přístupová práva musí platit také v databázi vektorů (kdo smí hledat v jakých dokumentech),
- externí poskytovatel embeddingů zpracovává vaše texty; zkontrolujte jeho podmínky; viz AI chatboti a soukromí dat a AI a ochrana osobních údajů (GDPR),
- útoky typu prompt injection mohou využít škodlivý text uložený v databázi; viz Prompt injection.
Jak embeddingy využít v praxi
- Firemní znalostní báze: zaměstnanci hledají odpovědi v interních dokumentech podle významu, ne podle klíčových slov.
- Zákaznický servis: podobné dotazy se seskupí a nejčastější témata se odhalí.
- E-shop: doporučování podobných produktů podle popisu.
- Třídění e-mailů či zpětné vazby bez ručního označování.
- Hledání duplicit v dokumentech.
Před nasazením vždy ověřte kvalitu na reálných příkladech: spočítejte, zda nejlepší nalezený dokument skutečně odpovídá dotazu, a dokumentujte případy selhání.
Embeddingy, jazykové modely a agenti
Jazykový model podle Googlu odhaduje pravděpodobnost tokenu v posloupnosti; embeddingy představují jiný, ale příbuzný nástroj: nepředpovídají další slovo, ale reprezentují význam. V agentních systémech slouží embeddingy často jako paměť: agent si ukládá poznatky či dokumenty jako vektory a při další úloze si vyhledá ty nejrelevantnější. Anthropic v popisu agentních systémů označuje jako základní stavební blok „rozšířený LLM“, tedy model doplněný o vyhledávání, nástroje a paměť (Building effective agents); vektorové vyhledávání je typickým způsobem realizace takového vyhledávání. Více o agentech viz AI agent, nebo workflow?.
Kdy embeddingy nestačí
Vektorové vyhledávání je silné tam, kde hledáte podle významu, ale slabší u přesných údajů (čísla smluv, jména, kódy výrobků), u rozsáhlých tabulek či u dotazů, které vyžadují výpočet nebo logiku. Pro takové úlohy se často kombinuje s klasickým fulltextovým vyhledáváním a filtry (například podle data, oddělení, oprávnění). Také pamatujte, že když se dokumenty změní, je nutné aktualizovat vektory; jinak AI vychází ze zastaralých údajů. Praktické pravidlo: výsledky vyhledávání zobrazujte uživateli spolu se zdrojem, aby je mohl ověřit.
Doporučená míra opatrnosti
Zacházejte s embeddingy a vektorovými databázemi jako s datovým úložištěm s citlivým obsahem: šifrování, kontrola přístupu, zálohy a minimalizace dat. Pokud vkládáte osobní údaje, vyhodnoťte právní základ a informujte dotčené osoby; viz AI a ochrana osobních údajů (GDPR).
Praktický příklad (smyšlený)
Firma s 3 000 interními směrnicemi zavede vyhledávání podle významu. Texty rozdělí na odstavce, převede na vektory a uloží do vektorové databáze. Zaměstnanec napíše „Můžu si vzít dovolenou po zkušební době?“ a systém najde odstavec o nároku na dovolenou, přestože se v něm slova „zkušební doba“ nevyskytují. Správce oprávnění dbá, aby zaměstnanci neviděli dokumenty, ke kterým nemají přístup. Příklad je smyšlený.
Embedding převádí text na vektor čísel; vzdálenost vektorů měří podobnost významu. Slouží k vyhledávání, shlukování, doporučování a klasifikaci a je základem RAG, ale nezaručuje pravdivost ani anonymitu.
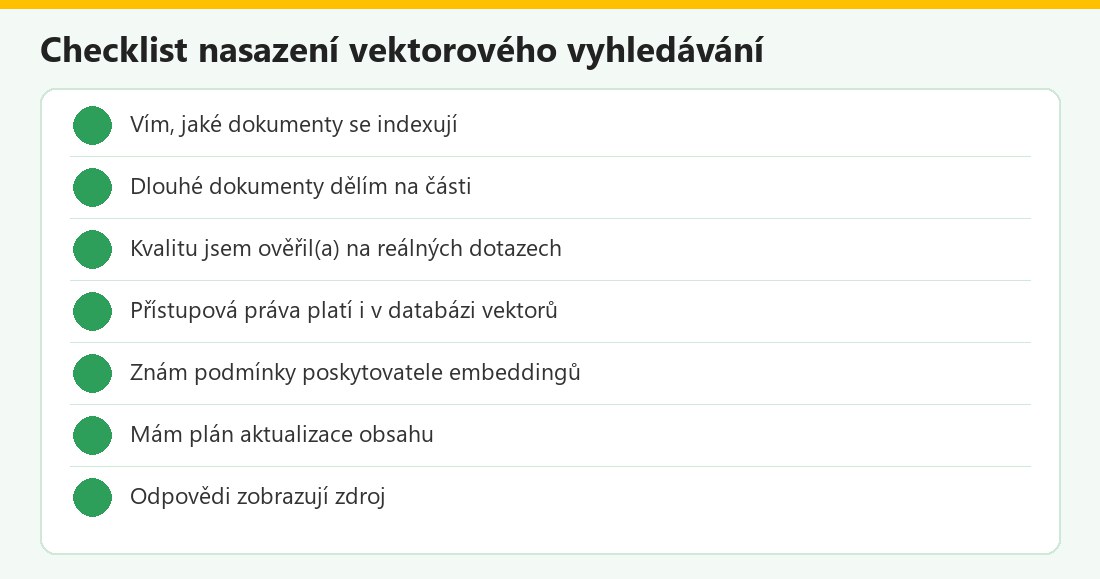 Kontrolní seznam – vlastní infografika
Embeddingy v kostce
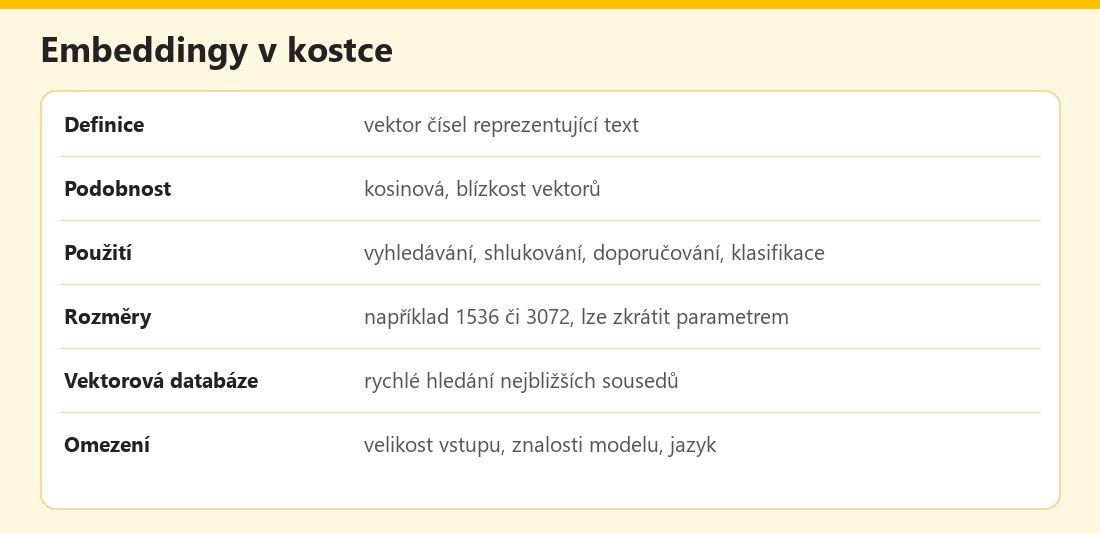 Základní údaje – vlastní infografika
Výhody a nevýhody
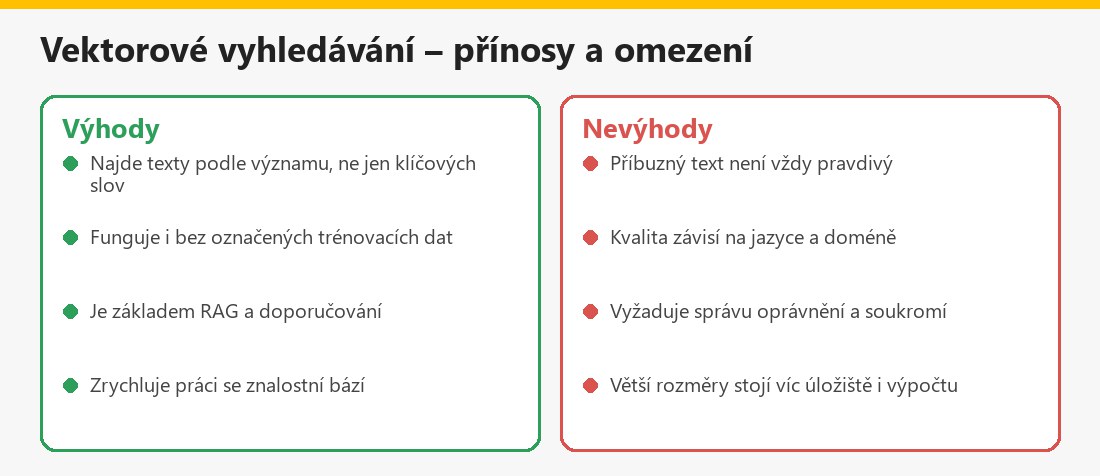 Souhrn – vlastní infografika
Související články
V kategorii Základy a principy AI najdete také Multimodální AI a Jak se trénuje AI model.
Shrnutí
Embedding je vektor čísel reprezentující text; vzdálenost vektorů měří podobnost významu. Používá se k vyhledávání, shlukování, doporučování, detekci anomálií a klasifikaci a je základem RAG. OpenAI doporučuje kosinovou podobnost a vektorovou databázi; rozměry (1536, 3072) lze zkrátit. Pozor na omezení, jazyk a soukromí: příbuzné není totéž co pravdivé. Nejde o technický návod.
Často kladené otázky k embeddingům
Co je embedding?
Vektor čísel reprezentující textový řetězec; vzdálenost vektorů měří příbuznost textů.
K čemu slouží embeddingy?
K vyhledávání, shlukování, doporučování, detekci anomálií a klasifikaci.
Co je kosinová podobnost?
Míra podobnosti dvou vektorů; OpenAI ji doporučuje a jejich vektory jsou normalizované.
Co je vektorová databáze?
Databáze pro rychlé hledání nejbližších vektorů mezi velkým množstvím dat.
Mohu embedding zkrátit?
Ano, přes parametr dimensions; při ruční úpravě je nutná normalizace.
Jsou embeddingy anonymní?
Nelze to automaticky předpokládat; chraňte je jako citlivá data.
Jak souvisí s RAG?
Embeddingy slouží k výběru nejpodobnějších úseků dokumentů, které se předají modelu.
Je to technický návod?
Ne, jde o obecné shrnutí.
